En GEO, on travaille surtout à l’aveugle. On pose des questions à ChatGPT, Perplexity ou Gemini, on relève les sources citées, puis on essaie de deviner pourquoi celles-là et pas les nôtres.
Le 17 octobre 2026, DeepSeek a changé un peu la donne : son moteur de recherche est désormais interrogeable par API, et chaque résultat arrive avec une note d’autorité et une note de classement. Pour la première fois, on peut lire ce qu’un moteur IA pense d’une source avant qu’un modèle ne s’en serve pour répondre.
Voici ce que dit la documentation, ce qu’un premier test public a montré, et ce que j’en retiens pour piloter la visibilité d’une marque dans les réponses IA.
À retenir
L’API Search de DeepSeek renvoie, pour chaque résultat, une note
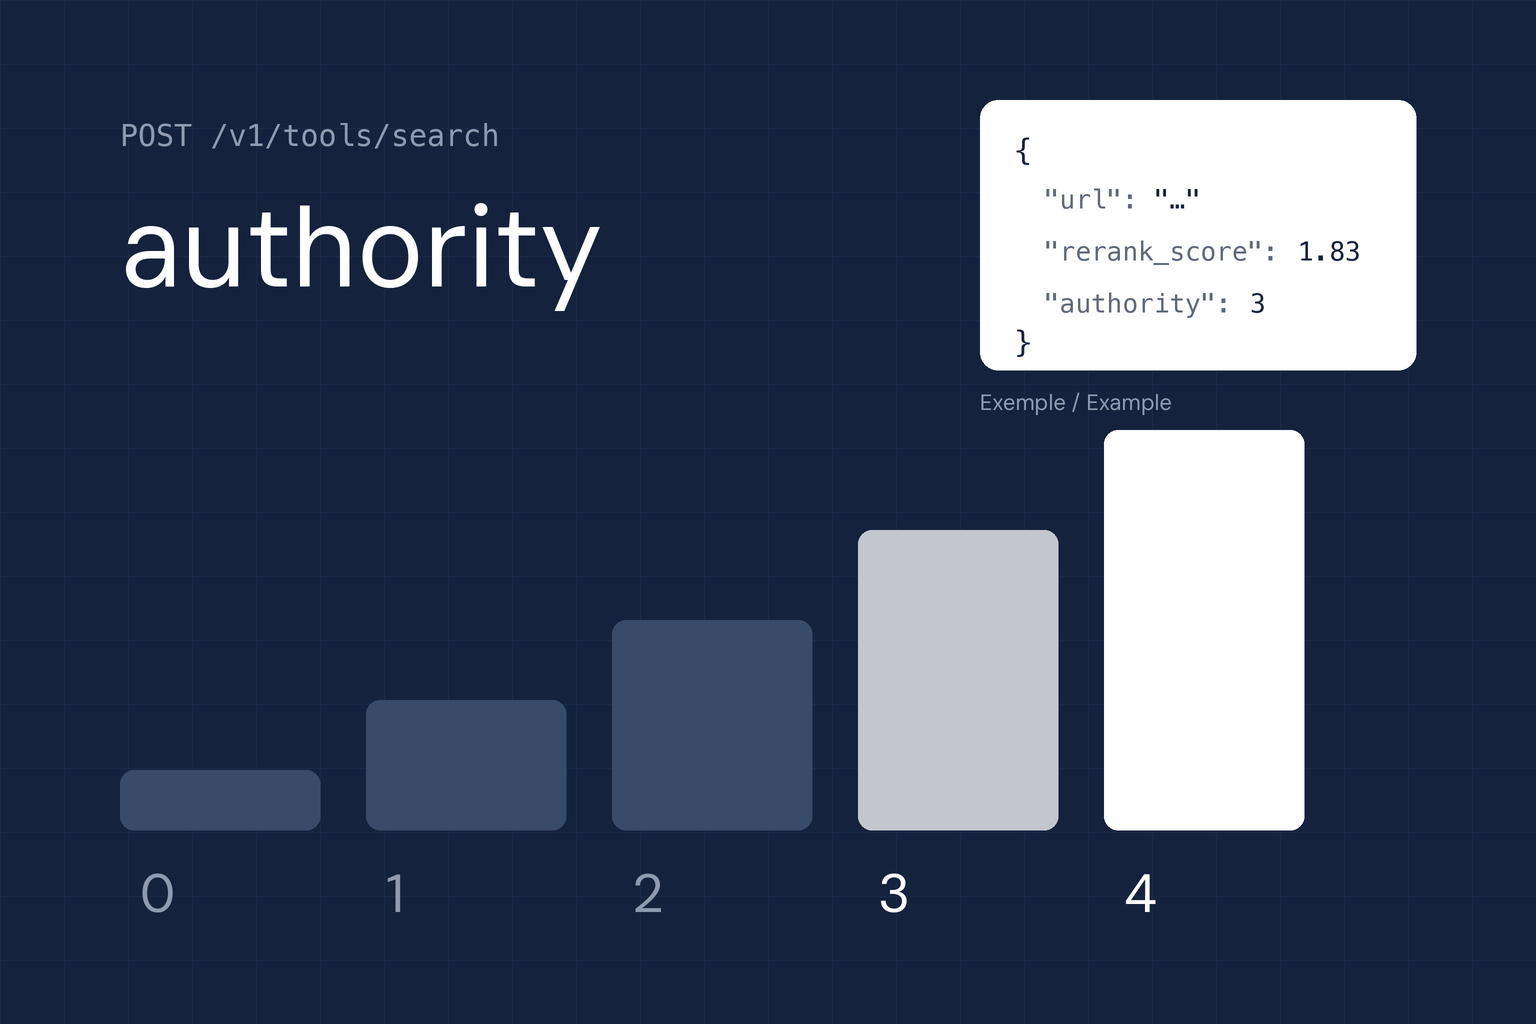
authorityde 0 à 4 et une notererank_scorede 0 à 3.Dans le premier test publié, l’autorité s’est comportée comme une note attribuée à l’hôte (le site ou le sous-domaine), pas à la page.
Conséquence directe : un bon contenu sur un site peu noté part avec un handicap, et du contenu parasite hébergé sur un site très noté hérite de sa note.
Les pages sans date lisible disparaissent dès qu’un filtre de date est appliqué.
Ces observations viennent d’une journée de tests depuis un seul pays. Ce sont des pistes à vérifier, pas des règles.
Ce que DeepSeek a ouvert
D’après son journal des mises à jour, DeepSeek s’appuie sur son propre moteur de recherche, qui indexerait « des centaines de milliards de pages » et traiterait « des centaines de millions de requêtes par jour ». L’éditeur affirme aussi filtrer « le spam SEO, la manipulation GEO et les contenus IA de faible qualité ».
Deux API sont ouvertes (documentation Search & Fetch) :
Search (
POST /v1/tools/search) : renvoie jusqu’à 50 résultats structurés pour une requête de 128 caractères maximum. Elle accepte les opérateurssite:,-site:,after:etbefore:, et un champlocalizationqui prend une adresse IP pour localiser les résultats.Fetch (
POST /v1/tools/fetch) : récupère une page et la renvoie en Markdown.
Côté prix, l’annonce de DeepSeek reprise par Suganthan indique 0,75 $ pour 1 000 appels par API. La documentation précise qu’un appel n’est facturé que s’il renvoie des résultats, et que le nombre de résultats demandés ne change pas le prix. Une centaine de requêtes revient donc à moins de 0,10 $.
Deux notes à lire sur chaque résultat
| Champ | Échelle | Définition officielle |
|---|---|---|
authority | 0 à 4 (-1 = inconnu) | Niveau d’autorité de la page. À partir de 3, la source est jugée très fiable. |
rerank_score | 0 à 3 | Note qui combine pertinence, autorité et fraîcheur. À partir de 1,5, le résultat est jugé de bonne qualité. |
Ces définitions viennent de la référence de l’API Search. Le point important : la documentation parle d’une note de page. Le premier test public suggère autre chose.
Ce que montre le premier test public
Le 17 octobre, jour de l’ouverture, Suganthan a publié un test détaillé : 110 appels depuis Dubaï, pour environ 0,08 $. Tous les chiffres de cette partie viennent de son article. Je ne les ai pas reproduits.
Les notes semblent hiérarchiser les résultats
Sur 1 000 résultats issus de 20 requêtes SEO et GEO, la note de classement allait de 0,75 à 2,70, avec une médiane de 1,63. Les résultats étaient triés selon cette note, et 68 % dépassaient le seuil de 1,5.
| Autorité | Part des résultats | Note de classement médiane |
|---|---|---|
| 1 | 2 % | 0,95 |
| 2 | 32 % | 1,45 |
| 3 | 60 % | 1,83 |
| 4 | 6 % | 1,98 |
Plus l’autorité est haute, plus la note de classement médiane l’est aussi. Cette corrélation ne mesure pas le poids exact de l’autorité dans le classement, mais elle montre que le champ mérite d’être suivi.
L’autorité se comporte comme une note d’hôte
Sur 16 requêtes site: couvrant 12 hôtes, toutes les URL d’un même hôte avaient la même note. Quelques exemples relevés :
| Hôte | Autorité |
|---|---|
| suganthan.com, growth-memo.com | 1 |
| ipullrank.com, brodieclark.com, medium.com, reddit.com | 2 |
| ahrefs.com, moz.com, searchengineland.com, aleydasolis.com, linkedin.com | 3 |
| zenodo.org | 4 |
Le détail le plus parlant concerne Reddit : qh.reddit.com obtient 1, www.reddit.com obtient 2. L’unité semble donc être l’hôte (le sous-domaine), pas le domaine entier.
Sur une requête site:, son propre site remontait 50 pages, toutes notées 1. Être indexé ne suffit donc pas : l’indexation et la note sont deux choses séparées.
Les plateformes passent devant les éditeurs
Sur six requêtes décrivant précisément ses propres outils, ses pages arrivaient au mieux en 32e et 48e position, et quatre fois hors du top 50. Devant : PyPI, npm, Apify, le Chrome Web Store, wordpress.org ou GitHub. Sur une requête « outil », une fiche sur une plateforme reconnue a battu la page de l’éditeur lui-même.
Le filtre anti-spam laisse passer du parasite
Malgré la promesse de filtrage, le test a fait remonter :
des PDF « Free Robux Generator » déposés via un formulaire sur un hôte gouvernemental américain (oig.dc.gov), notés 4 ;
des pages « BEST CBD GUMMIES EXPOSED » sur un hôte de l’université Columbia, notées 4 ;
un ancien domaine de député britannique qui sert désormais du contenu casino, noté 3 et classé 2e sur « best casino sites uk ».
Ces cas ne disent pas combien de spam DeepSeek retire. Ils montrent qu’une note d’hôte élevée peut couvrir des pages qui ne la méritent pas. C’est exactement la mécanique du parasite SEO, transposée aux moteurs IA.
Sans date, une page disparaît des recherches filtrées
Les opérateurs after: et before: ont fonctionné sans erreur, mais ils ont aussi écarté toutes les pages sans date reconnue. Dans l’échantillon, 11 % des résultats n’avaient pas de date. Pour une requête d’actualité filtrée par date, ces pages ne remontent tout simplement plus.
Le robot de Fetch se présente comme Firefox
Les requêtes de l’API Fetch observées ne s’identifiaient pas comme DeepSeek : user agent Firefox 149 sous Linux, langue zh-CN, adresses IP Huawei Cloud à Hong Kong (AS136907). Le robot chargeait le CSS mais n’exécutait pas le JavaScript. Il a aussi renvoyé le contenu de trois URL interdites par robots.txt. L’auteur n’a pas pu vérifier si le robot lisait le fichier robots.txt.
Ces observations concernent l’API Fetch, pas forcément le robot qui construit l’index de DeepSeek.
Ce que j’en retiens pour le GEO
1. L’hôte devient l’unité de travail. Si la note se confirme au niveau de l’hôte, la question « où publier ? » pèse autant que « quoi publier ? ». Un contenu stratégique placé sur un sous-domaine isolé, un blog à part ou un microsite part avec la note de cet hôte, pas celle du site principal.
2. La présence sur les plateformes fait partie du travail GEO. Pour un outil ou un logiciel, une fiche propre et légitime sur la plateforme où vit ce type de produit (extension de navigateur, place de marché, annuaire spécialisé) peut remonter avant votre propre site. C’est un levier, pas un contournement.
3. Une date lisible par les machines n’est plus un détail. Date de publication et de mise à jour visibles sur la page et balisées en données structurées (datePublished, dateModified). Puis vérifier que le moteur les relève vraiment.
4. Le contenu doit exister sans JavaScript. Un robot qui ne l’exécute pas ne voit que le HTML initial. Les textes chargés après coup par JavaScript n’existent pas pour lui.
5. robots.txt ne suffit pas à contrôler l’accès. Pour ce robot, il n’a pas empêché la récupération des pages testées. Si une marque veut contrôler cet accès, le travail se fait au niveau du serveur, avec prudence : bloquer tout le réseau Huawei Cloud ou toutes les signatures Firefox toucherait aussi de vrais visiteurs.
Les limites de ces observations
L’échantillon est petit. Une journée, 110 appels, six requêtes cibles, un seul pays d’appel. L’auteur parle lui-même de résultats « indicatifs ».
La corrélation n’est pas une explication. On voit que les hôtes bien notés se classent mieux, pas de combien la note pèse face à la pertinence ou la fraîcheur.
DeepSeek n’est pas Google ni ChatGPT. Ses notes ne disent rien directement de la façon dont les autres moteurs jugent un site. Leur intérêt est ailleurs : c’est le seul moteur IA, à ce jour, qui montre ses notes. On s’en sert comme d’un laboratoire.
Le comportement peut changer. L’API a quelques jours. Les notes, les filtres et le robot peuvent évoluer sans préavis.
Refaire le test sur votre marché
Le test publié a été fait depuis Dubaï, sur des requêtes en anglais. Pour une marque française ou européenne, il faut le refaire dans ses propres conditions :
Relever la note de chaque hôte avec une requête
site:par domaine et par sous-domaine : le vôtre, et ceux de trois ou quatre concurrents.Choisir une vingtaine de requêtes qui comptent pour le chiffre d’affaires, pas pour l’ego : questions de comparaison, de choix, d’objection.
Fixer la localisation avec une adresse IP du marché visé. Sans ce champ, DeepSeek semble utiliser l’IP de l’appelant, et votre audit reflète l’endroit où tourne votre script.
Noter quatre valeurs par résultat : rang, URL, autorité, note de classement. Les rejouer à date fixe pour suivre l’évolution.
Tester avec et sans filtre de date pour repérer vos pages que le moteur considère sans date.
Un point de départ en Python, avec la clé API stockée dans une variable d’environnement :
import os, requests

API = "https://api.deepseek.com/v1/tools/search"
HEADERS = {"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"}

def search(query, ip, count=50):
    r = requests.post(API, headers=HEADERS, timeout=30,
                      json={"query": query, "count": count, "localization": ip})
    r.raise_for_status()
    return [(rank, x["url"], x["authority"], x["rerank_score"], x["date"])
            for rank, x in enumerate(r.json()["results"], start=1)]
Une centaine d’appels facturés coûte moins de 0,10 $ au tarif annoncé. Pour une première mesure, le budget n’est pas un frein.
En résumé
L’intérêt de cette API n’est pas la part de marché de DeepSeek en Europe, qui reste modeste. C’est qu’elle rend visibles des notes que les autres moteurs IA gardent pour eux. Pour la première fois, on peut mesurer comment un moteur juge une source, au lieu de le supposer.
Les premiers résultats vont dans un sens que le SEO connaît bien : la réputation de l’hôte compte, la distribution compte, les signaux techniques de base (date, HTML lisible) comptent. Le GEO ne remplace pas ces fondamentaux. Il les rend plus visibles.
Sources : journal des mises à jour DeepSeek (17 octobre 2026), documentation Search & Fetch, référence de l’API Search, test publié par Suganthan.