Im GEO arbeiten wir meist im Blindflug. Wir stellen ChatGPT, Perplexity oder Gemini Fragen, notieren die zitierten Quellen und versuchen dann zu erraten, warum gerade diese zitiert werden und nicht unsere.
Am 17. Oktober 2026 hat DeepSeek die Lage ein Stück weit verändert: Seine Suchmaschine lässt sich jetzt per API abfragen, und jedes Ergebnis wird mit einer Autoritätsnote und einer Ranking-Note ausgeliefert. Zum ersten Mal lässt sich ablesen, was eine KI-Suchmaschine von einer Quelle hält, bevor ein Modell sie für eine Antwort verwendet.
Hier lesen Sie, was die Dokumentation sagt, was ein erster öffentlicher Test gezeigt hat und welche Schlüsse ich daraus für die Steuerung der Sichtbarkeit einer Marke in KI-Antworten ziehe.
Das Wichtigste in Kürze
Die Search-API von DeepSeek liefert für jedes Ergebnis eine Note
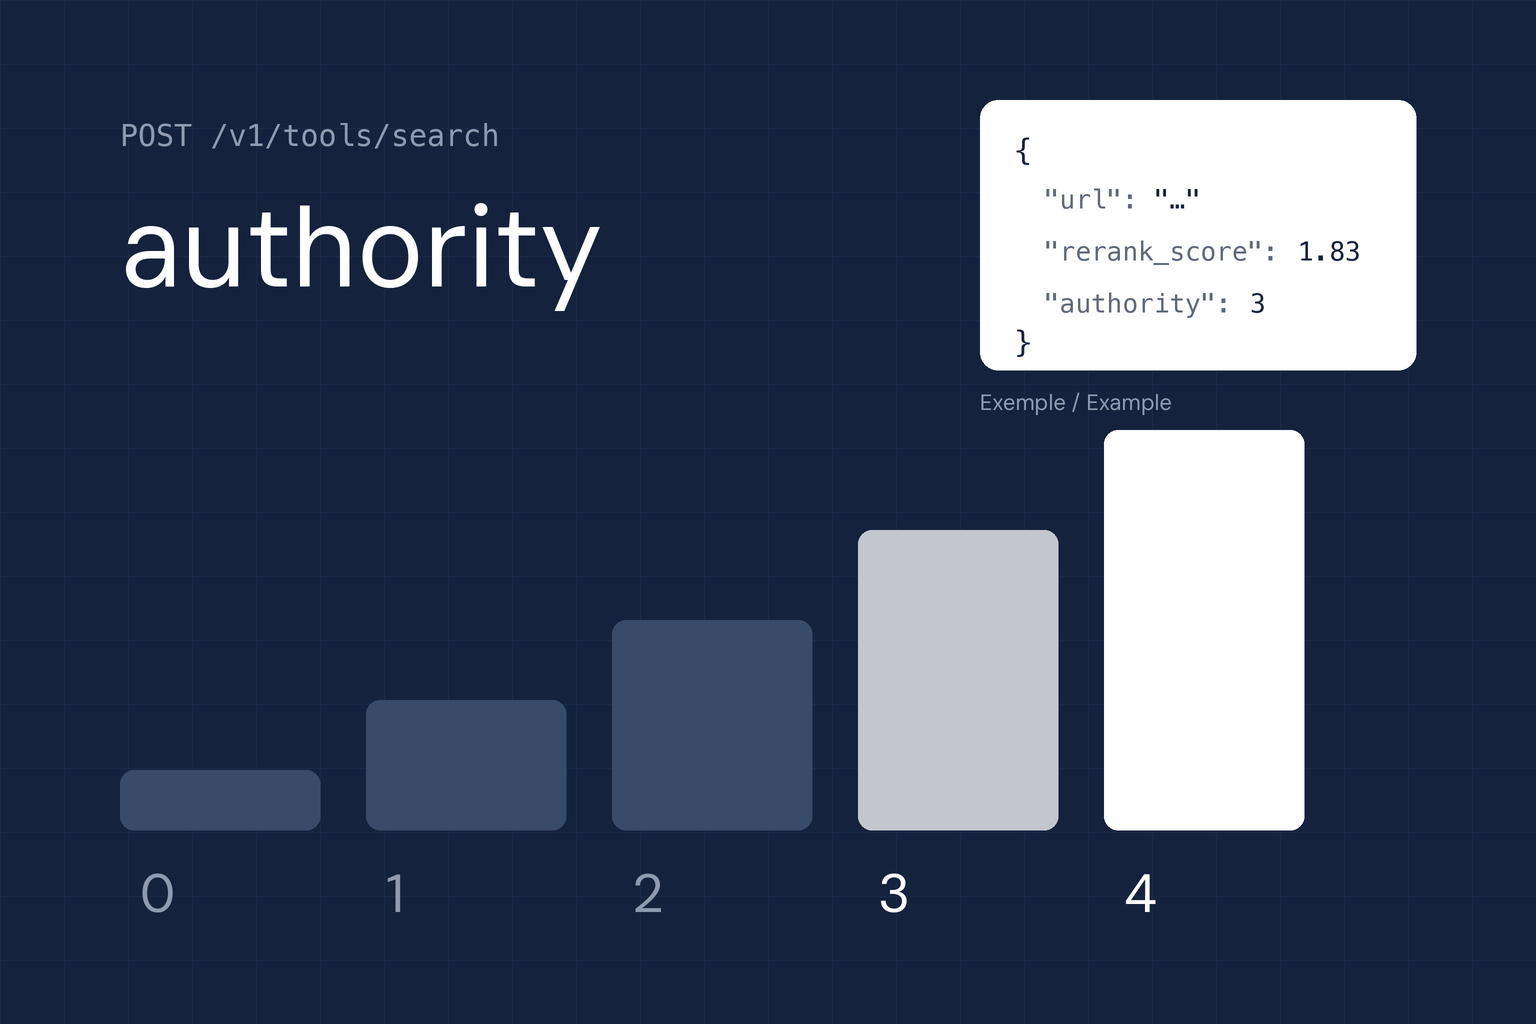
authorityvon 0 bis 4 und eine Notererank_scorevon 0 bis 3.Im ersten veröffentlichten Test verhielt sich die Autorität wie eine Note, die dem Host (der Website oder der Subdomain) zugewiesen wird, nicht der einzelnen Seite.
Die direkte Folge: Guter Content auf einer schwach bewerteten Website startet mit einem Handicap, und parasitärer Content auf einer hoch bewerteten Website erbt deren Note.
Seiten ohne lesbares Datum verschwinden, sobald ein Datumsfilter angewendet wird.
Diese Beobachtungen stammen aus einem einzigen Testtag in einem einzigen Land. Es sind Hinweise, die zu prüfen sind, keine Regeln.
Was DeepSeek geöffnet hat
Laut seinem Änderungsprotokoll stützt sich DeepSeek auf eine eigene Suchmaschine, die „Hunderte Milliarden Seiten“ indexieren und „Hunderte Millionen Anfragen pro Tag“ verarbeiten soll. Der Anbieter gibt außerdem an, „SEO-Spam, GEO-Manipulation und minderwertige KI-Inhalte“ herauszufiltern.
Zwei APIs stehen offen (Dokumentation Search & Fetch):
Search (
POST /v1/tools/search): liefert bis zu 50 strukturierte Ergebnisse für eine Anfrage mit maximal 128 Zeichen. Sie akzeptiert die Operatorensite:,-site:,after:undbefore:sowie ein Feldlocalization, das eine IP-Adresse entgegennimmt, um die Ergebnisse zu lokalisieren.Fetch (
POST /v1/tools/fetch): ruft eine Seite ab und gibt sie als Markdown zurück.
Zum Preis: Laut der von Suganthan zitierten Ankündigung von DeepSeek kosten 1.000 Aufrufe 0,75 $ pro API. Die Dokumentation stellt klar, dass ein Aufruf nur berechnet wird, wenn er Ergebnisse liefert, und dass die Zahl der angeforderten Ergebnisse den Preis nicht verändert. Rund hundert Anfragen kosten also weniger als 0,10 $.
Zwei Noten, die Sie bei jedem Ergebnis lesen sollten
| Feld | Skala | Offizielle Definition |
|---|---|---|
authority | 0 bis 4 (-1 = unbekannt) | Autoritätsniveau der Seite. Ab 3 gilt die Quelle als sehr vertrauenswürdig. |
rerank_score | 0 bis 3 | Note, die Relevanz, Autorität und Aktualität kombiniert. Ab 1,5 gilt das Ergebnis als qualitativ gut. |
Diese Definitionen stammen aus der Referenz der Search-API. Der entscheidende Punkt: Die Dokumentation spricht von einer Note für die Seite. Der erste öffentliche Test deutet auf etwas anderes hin.
Was der erste öffentliche Test zeigt
Am 17. Oktober, dem Tag der Freischaltung, hat Suganthan einen ausführlichen Test veröffentlicht: 110 Aufrufe aus Dubai für rund 0,08 $. Alle Zahlen in diesem Abschnitt stammen aus seinem Artikel. Ich habe sie nicht selbst nachgeprüft.
Die Noten scheinen die Ergebnisse zu ordnen
Bei 1.000 Ergebnissen aus 20 SEO- und GEO-Anfragen reichte die Ranking-Note von 0,75 bis 2,70, mit einem Median von 1,63. Die Ergebnisse waren nach dieser Note sortiert, und 68 % lagen über der Schwelle von 1,5.
| Autorität | Anteil der Ergebnisse | Median der Ranking-Note |
|---|---|---|
| 1 | 2 % | 0,95 |
| 2 | 32 % | 1,45 |
| 3 | 60 % | 1,83 |
| 4 | 6 % | 1,98 |
Je höher die Autorität, desto höher auch der Median der Ranking-Note. Diese Korrelation misst nicht das genaue Gewicht der Autorität im Ranking, zeigt aber, dass es sich lohnt, das Feld zu beobachten.
Die Autorität verhält sich wie eine Host-Note
Bei 16 site:-Anfragen zu 12 Hosts hatten alle URLs desselben Hosts dieselbe Note. Einige der erfassten Beispiele:
| Host | Autorität |
|---|---|
| suganthan.com, growth-memo.com | 1 |
| ipullrank.com, brodieclark.com, medium.com, reddit.com | 2 |
| ahrefs.com, moz.com, searchengineland.com, aleydasolis.com, linkedin.com | 3 |
| zenodo.org | 4 |
Das aufschlussreichste Detail betrifft Reddit: qh.reddit.com erhält 1, www.reddit.com erhält 2. Die Bezugseinheit scheint also der Host (die Subdomain) zu sein, nicht die gesamte Domain.
Bei einer site:-Anfrage lieferte seine eigene Website 50 Seiten, alle mit der Note 1. Indexiert zu sein reicht also nicht: Indexierung und Note sind zwei getrennte Dinge.
Plattformen ziehen an den Anbietern vorbei
Bei sechs Anfragen, die seine eigenen Tools genau beschrieben, landeten seine Seiten bestenfalls auf Position 32 und 48, und viermal außerhalb der Top 50. Davor: PyPI, npm, Apify, der Chrome Web Store, wordpress.org oder GitHub. Bei einer „Tool“-Anfrage schlug ein Eintrag auf einer anerkannten Plattform die Seite des Anbieters selbst.
Der Spamfilter lässt parasitären Content durch
Trotz des Filterversprechens brachte der Test Folgendes nach oben:
„Free Robux Generator“-PDFs, die über ein Formular auf einem US-Regierungshost (oig.dc.gov) hochgeladen wurden, mit der Note 4;
„BEST CBD GUMMIES EXPOSED“-Seiten auf einem Host der Columbia University, mit der Note 4;
eine ehemalige Domain eines britischen Abgeordneten, die inzwischen Casino-Content ausliefert, mit der Note 3 und auf Platz 2 für „best casino sites uk“.
Diese Fälle sagen nichts darüber aus, wie viel Spam DeepSeek entfernt. Sie zeigen, dass eine hohe Host-Note Seiten abdecken kann, die sie nicht verdienen. Das ist genau die Mechanik von Parasite SEO, übertragen auf KI-Suchmaschinen.
Ohne Datum verschwindet eine Seite aus gefilterten Suchen
Die Operatoren after: und before: funktionierten fehlerfrei, schlossen aber auch alle Seiten ohne erkanntes Datum aus. In der Stichprobe hatten 11 % der Ergebnisse kein Datum. Bei einer nach Datum gefilterten News-Anfrage tauchen diese Seiten schlicht nicht mehr auf.
Der Fetch-Crawler gibt sich als Firefox aus
Die beobachteten Anfragen der Fetch-API gaben sich nicht als DeepSeek zu erkennen: User Agent Firefox 149 unter Linux, Sprache zh-CN, IP-Adressen von Huawei Cloud in Hongkong (AS136907). Der Crawler lud das CSS, führte aber kein JavaScript aus. Er lieferte außerdem den Inhalt von drei URLs zurück, die per robots.txt gesperrt waren. Ob der Crawler die robots.txt überhaupt las, konnte der Autor nicht überprüfen.
Diese Beobachtungen betreffen die Fetch-API, nicht unbedingt den Crawler, der den Index von DeepSeek aufbaut.
Was ich daraus für GEO mitnehme
1. Der Host wird zur Arbeitseinheit. Bestätigt sich die Note auf Host-Ebene, wiegt die Frage „Wo veröffentlichen?“ ebenso schwer wie „Was veröffentlichen?“. Strategischer Content auf einer isolierten Subdomain, einem separaten Blog oder einer Microsite startet mit der Note dieses Hosts, nicht mit der der Hauptwebsite.
2. Präsenz auf Plattformen gehört zur GEO-Arbeit. Für ein Tool oder eine Software kann ein sauberer, legitimer Eintrag auf der Plattform, auf der diese Art von Produkt zu Hause ist (Browser-Erweiterung, Marktplatz, Fachverzeichnis), vor Ihrer eigenen Website erscheinen. Das ist ein Hebel, keine Umgehung.
3. Ein maschinenlesbares Datum ist kein Detail mehr. Veröffentlichungs- und Aktualisierungsdatum sichtbar auf der Seite und als strukturierte Daten ausgezeichnet (datePublished, dateModified). Anschließend prüfen, ob die Suchmaschine sie tatsächlich erfasst.
4. Der Content muss ohne JavaScript existieren. Ein Crawler, der es nicht ausführt, sieht nur das initiale HTML. Texte, die erst nachträglich per JavaScript geladen werden, existieren für ihn nicht.
5. robots.txt allein reicht zur Zugriffskontrolle nicht aus. Bei diesem Crawler hat sie den Abruf der getesteten Seiten nicht verhindert. Wenn eine Marke diesen Zugriff kontrollieren will, geschieht das auf Serverebene, und zwar mit Vorsicht: Das gesamte Huawei-Cloud-Netz oder alle Firefox-Signaturen zu blockieren, würde auch echte Besucher treffen.
Die Grenzen dieser Beobachtungen
Die Stichprobe ist klein. Ein Tag, 110 Aufrufe, sechs Zielanfragen, ein einziges Herkunftsland der Aufrufe. Der Autor selbst spricht von „indikativen“ Ergebnissen.
Korrelation ist keine Erklärung. Wir sehen, dass gut bewertete Hosts besser ranken, aber nicht, wie stark die Note gegenüber Relevanz oder Aktualität ins Gewicht fällt.
DeepSeek ist weder Google noch ChatGPT. Seine Noten sagen nichts direkt darüber aus, wie andere Suchmaschinen eine Website bewerten. Ihr Wert liegt woanders: DeepSeek ist bislang die einzige KI-Suchmaschine, die ihre Noten offenlegt. Wir nutzen sie als Labor.
Das Verhalten kann sich ändern. Die API ist erst wenige Tage alt. Noten, Filter und Crawler können sich ohne Vorankündigung ändern.
Den Test für Ihren Markt wiederholen
Der veröffentlichte Test wurde aus Dubai mit englischsprachigen Anfragen durchgeführt. Eine französische oder europäische Marke muss ihn unter ihren eigenen Bedingungen wiederholen:
Die Note jedes Hosts erfassen, mit einer
site:-Anfrage pro Domain und pro Subdomain: für Ihre eigene und für die von drei oder vier Wettbewerbern.Rund zwanzig Anfragen auswählen, die zählen, und zwar für den Umsatz, nicht fürs Ego: Vergleichs-, Auswahl- und Einwandfragen.
Die Lokalisierung festlegen, mit einer IP-Adresse aus dem Zielmarkt. Ohne dieses Feld scheint DeepSeek die IP des Aufrufers zu verwenden, und Ihr Audit spiegelt dann den Ort wider, an dem Ihr Skript läuft.
Vier Werte pro Ergebnis festhalten: Rang, URL, Autorität, Ranking-Note. Die Abfragen zu festen Terminen wiederholen, um die Entwicklung zu verfolgen.
Mit und ohne Datumsfilter testen, um Ihre Seiten zu erkennen, die die Suchmaschine als undatiert einstuft.
Ein Ausgangspunkt in Python, mit dem API-Schlüssel in einer Umgebungsvariable:
import os, requests

API = "https://api.deepseek.com/v1/tools/search"
HEADERS = {"Authorization": f"Bearer {os.environ['DEEPSEEK_API_KEY']}"}

def search(query, ip, count=50):
    r = requests.post(API, headers=HEADERS, timeout=30,
                      json={"query": query, "count": count, "localization": ip})
    r.raise_for_status()
    return [(rank, x["url"], x["authority"], x["rerank_score"], x["date"])
            for rank, x in enumerate(r.json()["results"], start=1)]
Rund hundert berechnete Aufrufe kosten zum angekündigten Tarif weniger als 0,10 $. Für eine erste Messung ist das Budget kein Hindernis.
Fazit
Der Wert dieser API liegt nicht im Marktanteil von DeepSeek in Europa, der bescheiden bleibt. Er liegt darin, dass sie Noten sichtbar macht, die andere KI-Suchmaschinen für sich behalten. Zum ersten Mal lässt sich messen, wie eine Suchmaschine eine Quelle bewertet, statt es nur zu vermuten.
Die ersten Ergebnisse weisen in eine Richtung, die SEO gut kennt: Die Reputation des Hosts zählt, die Distribution zählt, die technischen Grundsignale (Datum, lesbares HTML) zählen. GEO ersetzt diese Grundlagen nicht. Es macht sie sichtbarer.
Quellen: Änderungsprotokoll von DeepSeek (17. Oktober 2026), Dokumentation Search & Fetch, Referenz der Search-API, von Suganthan veröffentlichter Test.