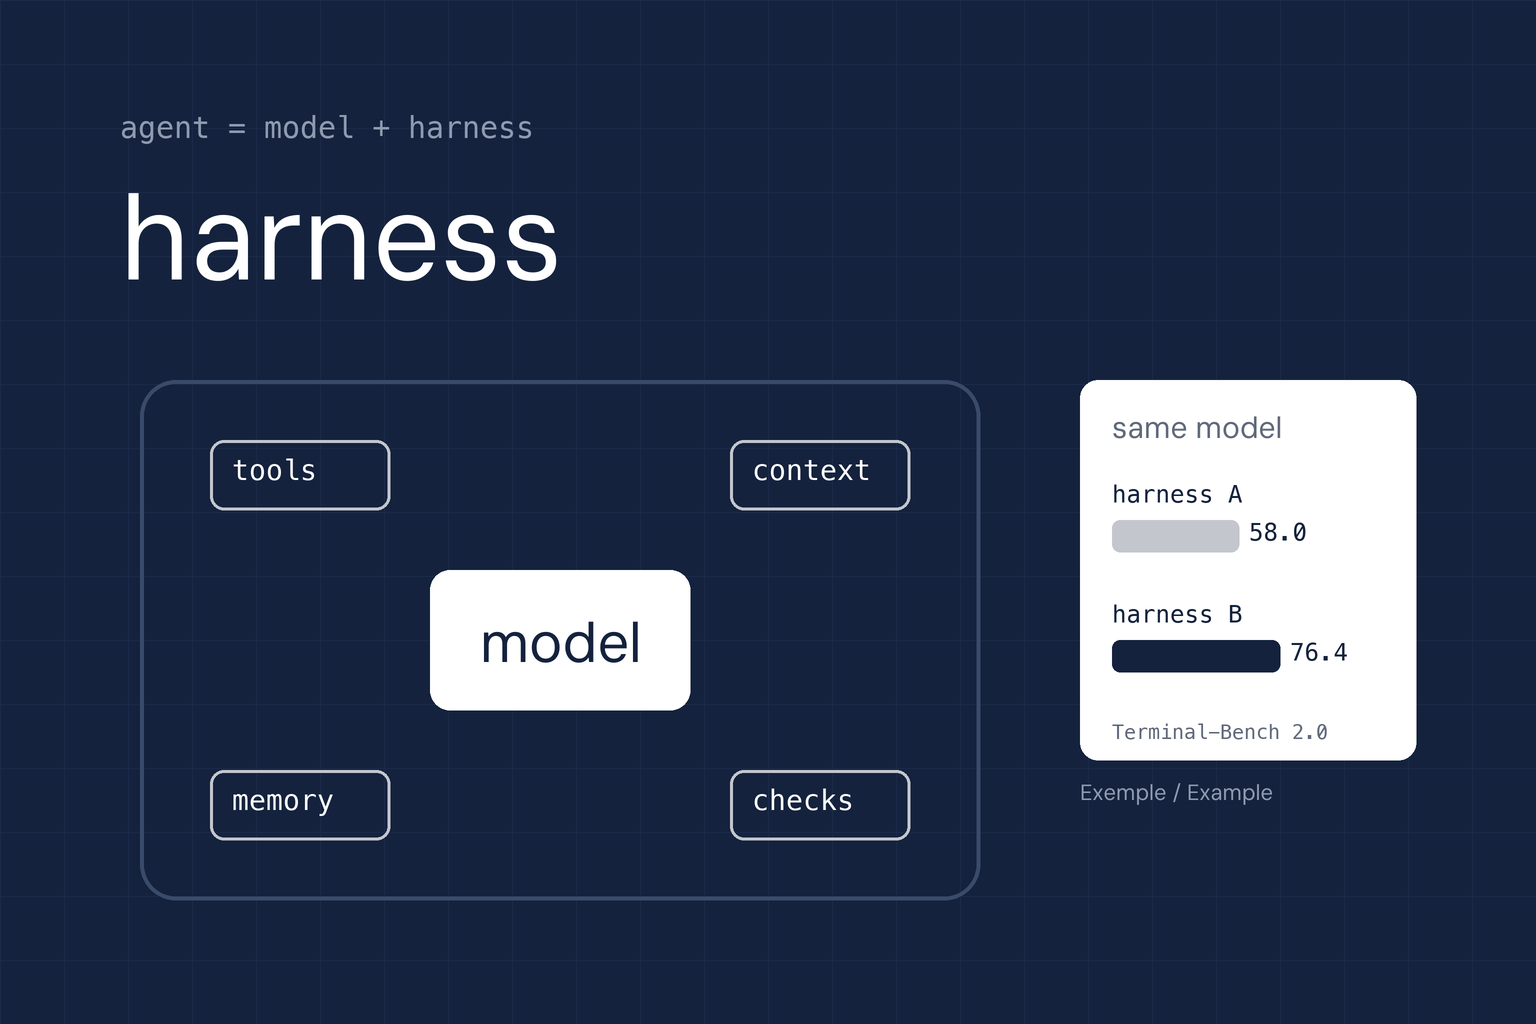
Quand on compare des agents IA, on compare presque toujours des modèles : Claude contre GPT, GPT contre Gemini. C’est regarder le moteur et oublier la voiture.
Depuis le début de 2026, un mot s’est imposé chez ceux qui construisent ces agents : le harness. C’est tout ce qui entoure le modèle et lui permet d’agir. Et les mesures publiées cette année montrent qu’il pèse au moins autant que le modèle sur le résultat.
J’utilise un harness tous les jours pour mon travail SEO et GEO. Voici ce que j’ai retenu des sources, comment je choisirais aujourd’hui, et la réponse honnête à la question que tout le monde pose : est-ce que ça améliore le SEO ?
À retenir
Un harness, c’est tout l’agent sauf le modèle : les outils, la gestion du contexte, la mémoire, les règles de sécurité, les boucles de vérification. LangChain le résume en une formule : Agent = Model + Harness.
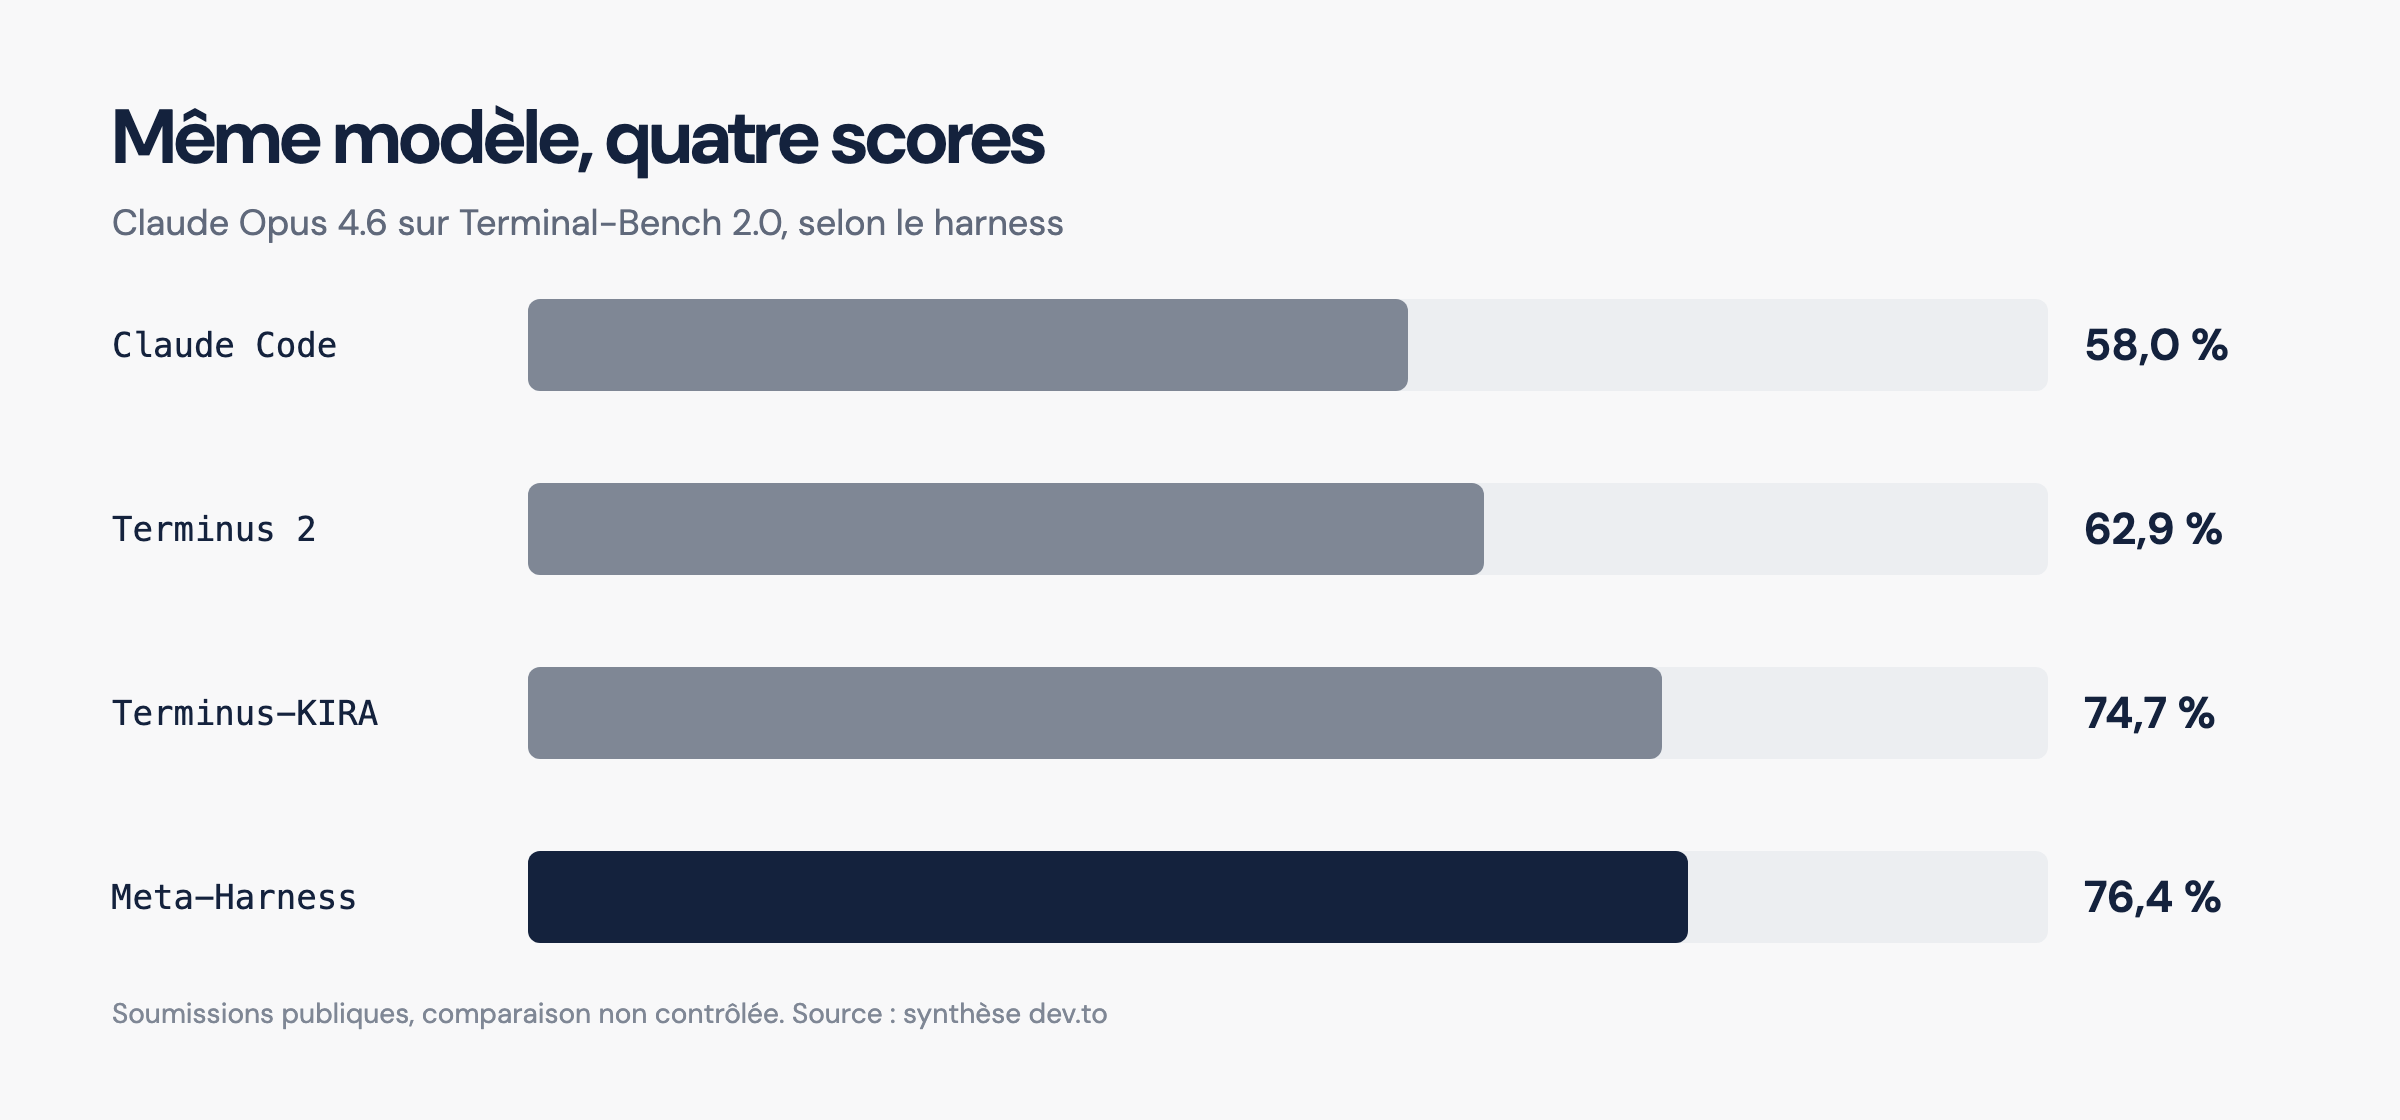
Sur un même benchmark, le même modèle passe de 58,0 % à 76,4 % selon le harness, d’après les chiffres repris de Terminal-Bench 2.0. Les auteurs préviennent que ce n’est pas une expérience contrôlée.
Une étude d’octobre 2026 sur 66 configurations montre que le classement des modèles s’inverse d’un harness à l’autre, et que le harness du fabricant n’est pas toujours le meilleur pour son propre modèle.
Il n’y a pas de meilleur harness dans l’absolu. Il y a un bon couple modèle et harness pour une tâche donnée, et il se teste.
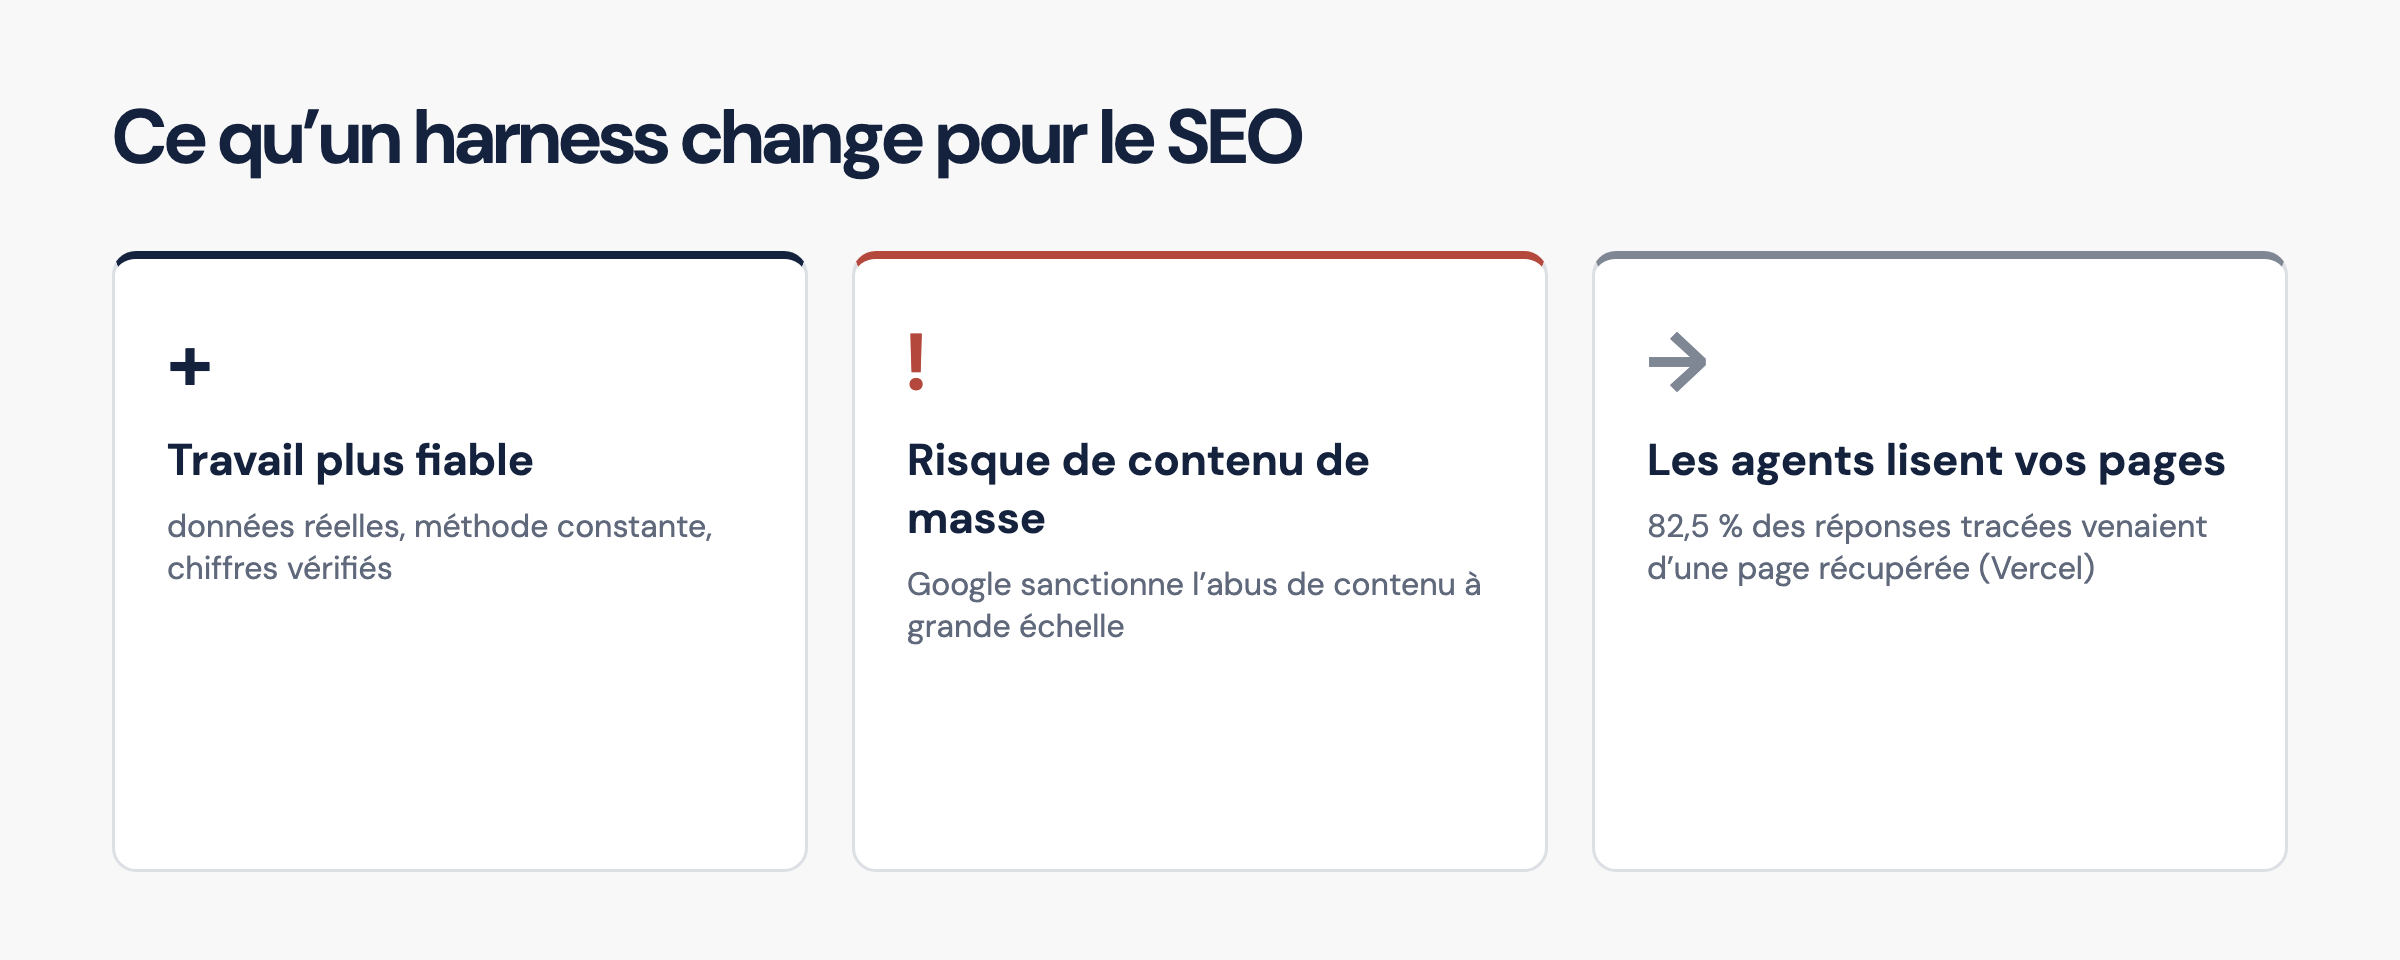
Un harness ne fait pas ranker un site. Il change la qualité et la régularité du travail SEO, et il peut aussi produire du contenu de masse que Google sanctionne. L’effet dépend de ce qu’on lui fait faire.
Un harness, c’est quoi ?
Le mot vient de l’équipement : le harnais qui relie le cheval à la charrue. Le cheval fournit la force, le harnais la rend utile. Appliqué aux agents IA, l’image tient bien.
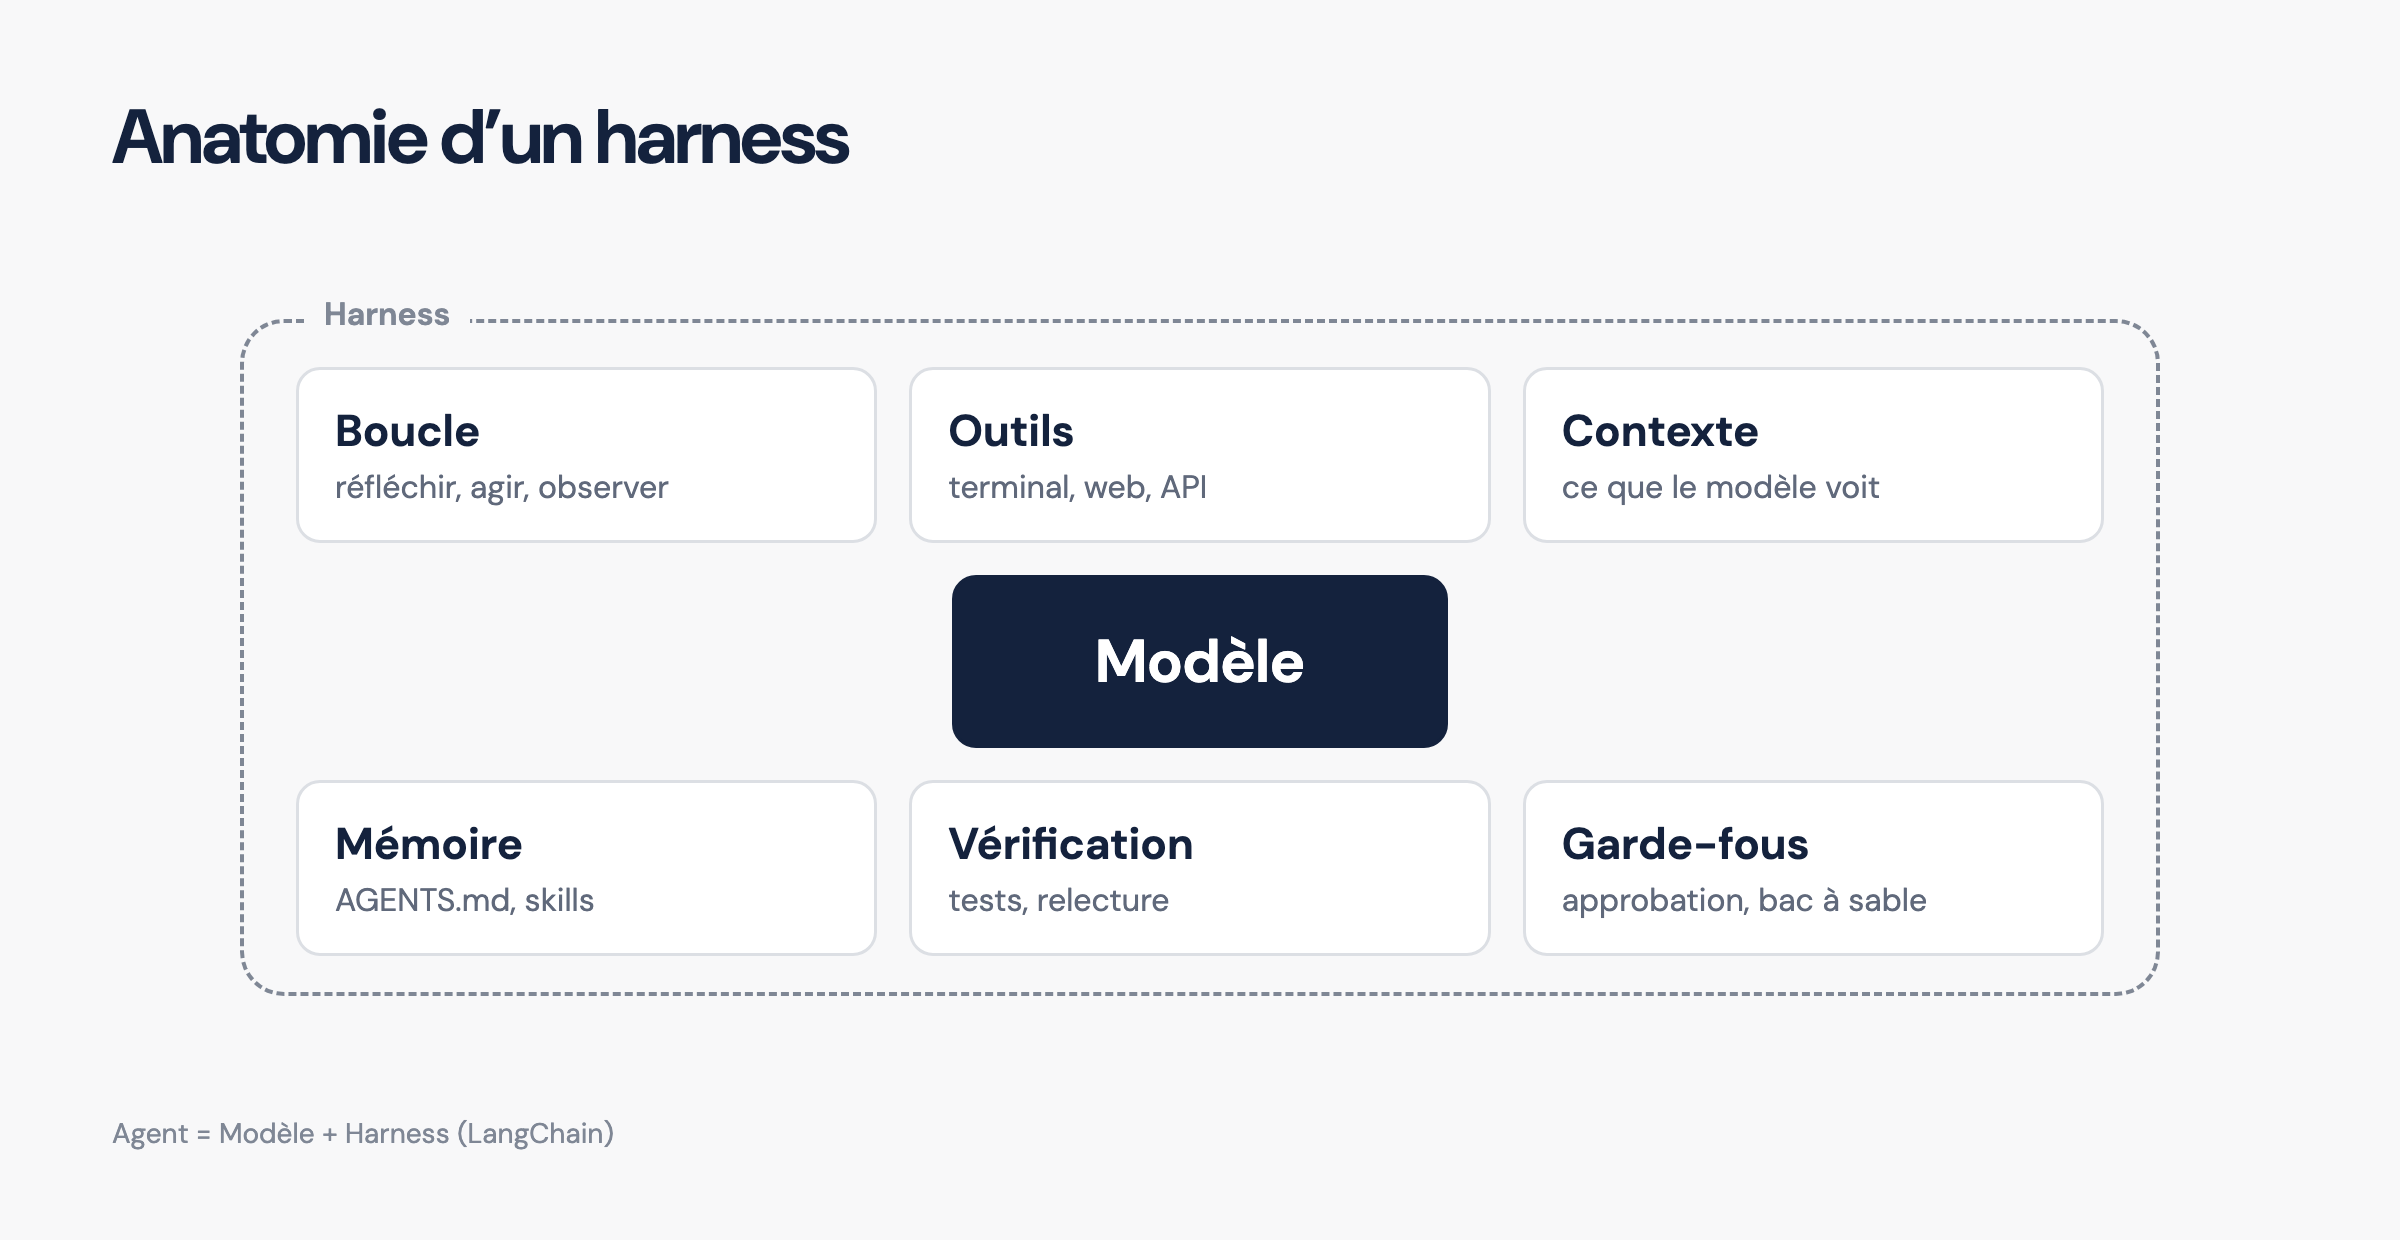
LangChain en donne la définition la plus citée : « Agent = Model + Harness ». Le modèle contient l’intelligence, le harness est le système qui la rend utile. Martin Fowler reprend la même idée : le terme désigne tout ce qu’il y a dans un agent sauf le modèle lui-même.
Concrètement, un modèle seul reçoit du texte et renvoie du texte. Il ne lit pas vos fichiers, n’ouvre pas un navigateur, ne se souvient de rien d’une session à l’autre. C’est le harness qui fait tout ça :
| Brique | Ce qu’elle fait | Exemple |
|---|---|---|
| Boucle d’agent | Fait tourner le modèle : il réfléchit, appelle un outil, lit le résultat, recommence | Le cœur de Claude Code, Codex ou Hermes |
| Outils | Donne des mains au modèle : terminal, fichiers, recherche web, navigateur | Un accès bash, une API Search Console |
| Contexte | Décide ce que le modèle voit à chaque tour et résume ce qui déborde | Compaction d’une longue session |
| Mémoire et consignes | Garde les règles et les apprentissages d’une session à l’autre | AGENTS.md, CLAUDE.md, skills |
| Vérification | Contrôle le travail avant qu’il n’arrive chez l’humain | Tests, linters, relecture par un second agent |
| Garde-fous | Bac à sable, demandes d’approbation, droits limités | Confirmation avant toute suppression |
OpenAI décrit le harness de Codex dans les mêmes termes : ce qui aide le modèle à rassembler le contexte, utiliser des outils, rester dans les limites configurées, demander une approbation et poursuivre le travail d’un tour à l’autre.
D’où vient le mot « harness engineering »
Le terme s’est popularisé au premier semestre 2026. Le 5 février, Mitchell Hashimoto, cofondateur de HashiCorp, publie son parcours d’adoption de l’IA, dont une étape s’intitule « Engineer the Harness ». Sa méthode est simple : chaque fois que l’agent se trompe de commande ou d’API, il ajoute une ligne dans le fichier AGENTS.md du projet. Chaque ligne correspond à une erreur observée.
OpenAI a ensuite publié son propre retour sous le titre « Harness engineering ». La leçon que je trouve la plus utile : donner à l’agent une carte, pas un manuel de 1 000 pages. Le contexte est une ressource rare. Un fichier de consignes géant écrase la tâche, et quand tout est « important », plus rien ne l’est.
Anthropic, de son côté, a documenté comment faire travailler un agent sur plusieurs sessions. Leur harness sépare un agent d’initialisation, qui prépare l’environnement, et un agent qui avance par petites étapes. Trois fichiers servent de fil conducteur : une liste de fonctionnalités en JSON que l’agent n’a le droit que de cocher, un fichier de progression, et l’historique git. Le problème qu’ils corrigent est très parlant : sans ce cadre, l’agent déclare le projet terminé trop tôt.
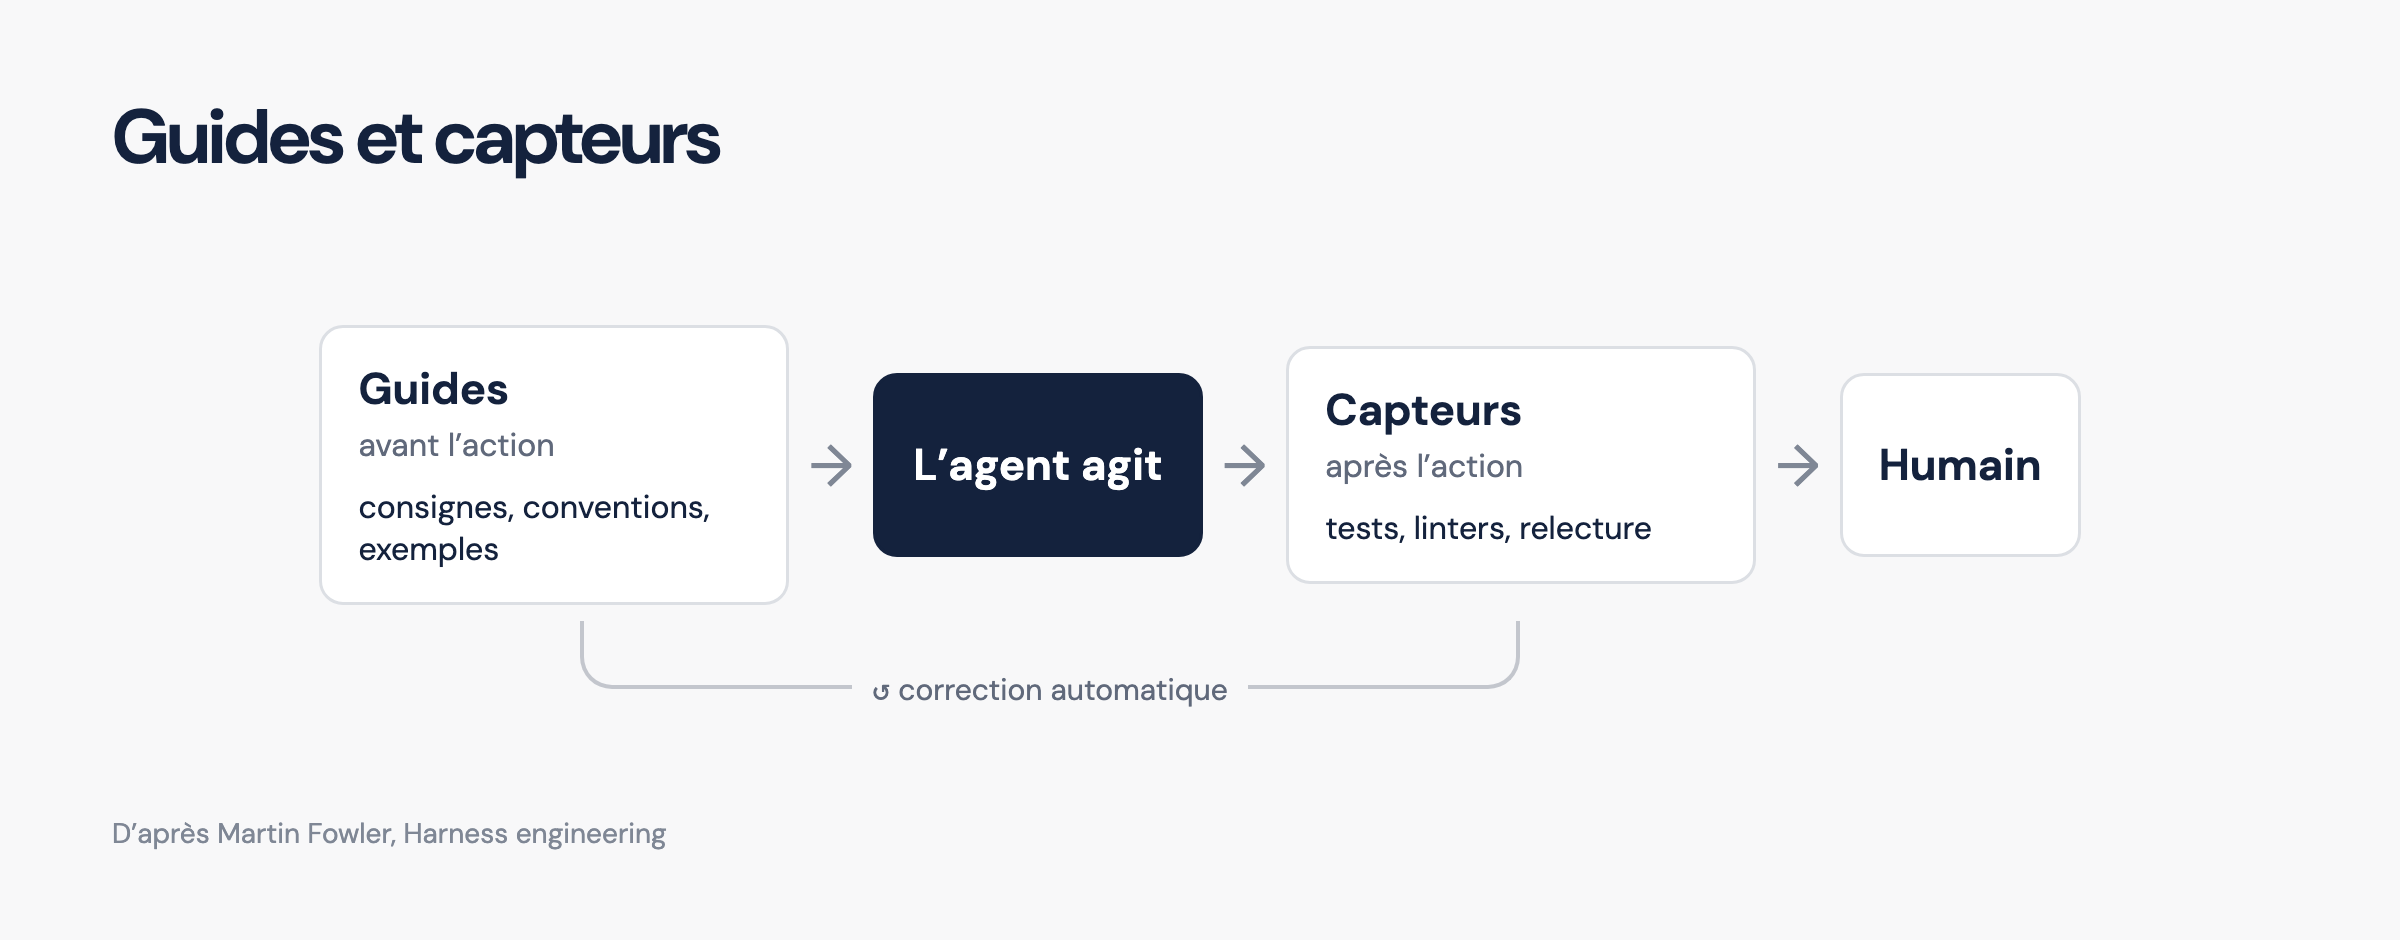
Martin Fowler propose la grille la plus claire pour penser tout ça. Un harness a deux types de contrôles : les guides, qui orientent l’agent avant qu’il n’agisse (consignes, conventions, exemples), et les capteurs, qui observent après coup et l’aident à se corriger (tests, linters, relecture). Un bon harness augmente les chances de réussir du premier coup et rattrape le maximum d’erreurs avant qu’un humain ne les voie.
Le harness pèse autant que le modèle
C’est la partie qui devrait changer la façon dont on choisit ses outils. Plusieurs mesures publiées en 2026 vont dans le même sens.
| Mesure | Même modèle, résultats selon le harness | Source |
|---|---|---|
| Terminal-Bench 2.0, Claude Opus 4.6 | 58,0 % avec Claude Code, 62,9 % avec Terminus 2, 74,7 % avec Terminus-KIRA, 76,4 % avec Meta-Harness | synthèse dev.to d’un article de recherche |
| Terminal-Bench 2.1, GLM-5.2 | 59,8 % avec OpenCode, 65,4 % avec Claude Code, 69,0 % avec Cursor, 72,6 % avec Kimchi | test publié par Kimchi |
| ARC-AGI-3, GPT-5.6 Sol | de 13,3 % à 38,3 % en conservant le raisonnement et en compactant le contexte, avec six fois moins de tokens en sortie | OpenAI |
L’étude la plus solide que j’ai trouvée vient de l’université technologique de Nanyang, publiée le 1er octobre 2026. Les auteurs ont testé 66 configurations : quatre harnesses configurables (OpenHands, DeepSeek Harness, Pi, openJiuwen) avec cinq modèles, sur trois benchmarks, plus les couples natifs Codex avec GPT et Claude Code avec Claude. Leurs conclusions :
Le classement des modèles s’inverse selon le harness. Sur Terminal-Bench 4, Claude devance GPT de 7,94 points dans OpenHands, mais il est derrière de 30,16 points dans Pi.
Le harness du fabricant n’est pas toujours le meilleur pour son propre modèle.
Payer plus ne garantit pas un meilleur score. Sur Terminal-Bench 4, GPT fait mieux sous Pi que sous DeepSeek Harness pour moins d’un quart du coût par tâche.
Ce qui fait la différence : la façon dont le harness renvoie les échecs au modèle, sous une forme qu’il sait exploiter.
Un article de position va plus loin et parle de « contrainte limitante » : sur les tâches longues et entre modèles de niveau comparable, la configuration du harness expliquerait davantage la variation des résultats que le choix du modèle. Les protocoles d’évaluation attribueraient donc au modèle des gains qui viennent du harness.
Les limites de ces chiffres
Ce ne sont pas mes mesures. Je n’ai reproduit aucun de ces tests. Les chiffres sont ceux des auteurs.
Les comparaisons publiques ne sont pas contrôlées. L’écart de 18 points sur Claude Opus 4.6 compare des soumissions qui peuvent différer par les prompts, les versions et les budgets de tokens. Les auteurs le disent eux-mêmes, et une partie du score de Claude Code venait de tâches cassées, corrigées dans la version 2.1 du benchmark.
Kimchi est juge et partie. Leur test classe leur propre harness en tête. Le résultat reste intéressant pour l’écart de 13 points, pas pour le podium.
Il existe un avis contraire. D’après la synthèse de The Deep Feed, les auteurs de Terminal-Bench estiment que le choix du modèle compte généralement plus que le harness. Le débat n’est pas tranché.
Les benchmarks de code ne sont pas des tâches SEO. Aucun de ces tests ne mesure un audit, une analyse de mots-clés ou une rédaction.
Ce qui reste solide, c’est la direction : le même modèle ne donne pas le même résultat dans deux harnesses différents. On ne peut plus choisir son outil en regardant seulement le nom du modèle.
Le paysage en 2026 : Hermes, OpenClaw, OpenBot et les autres
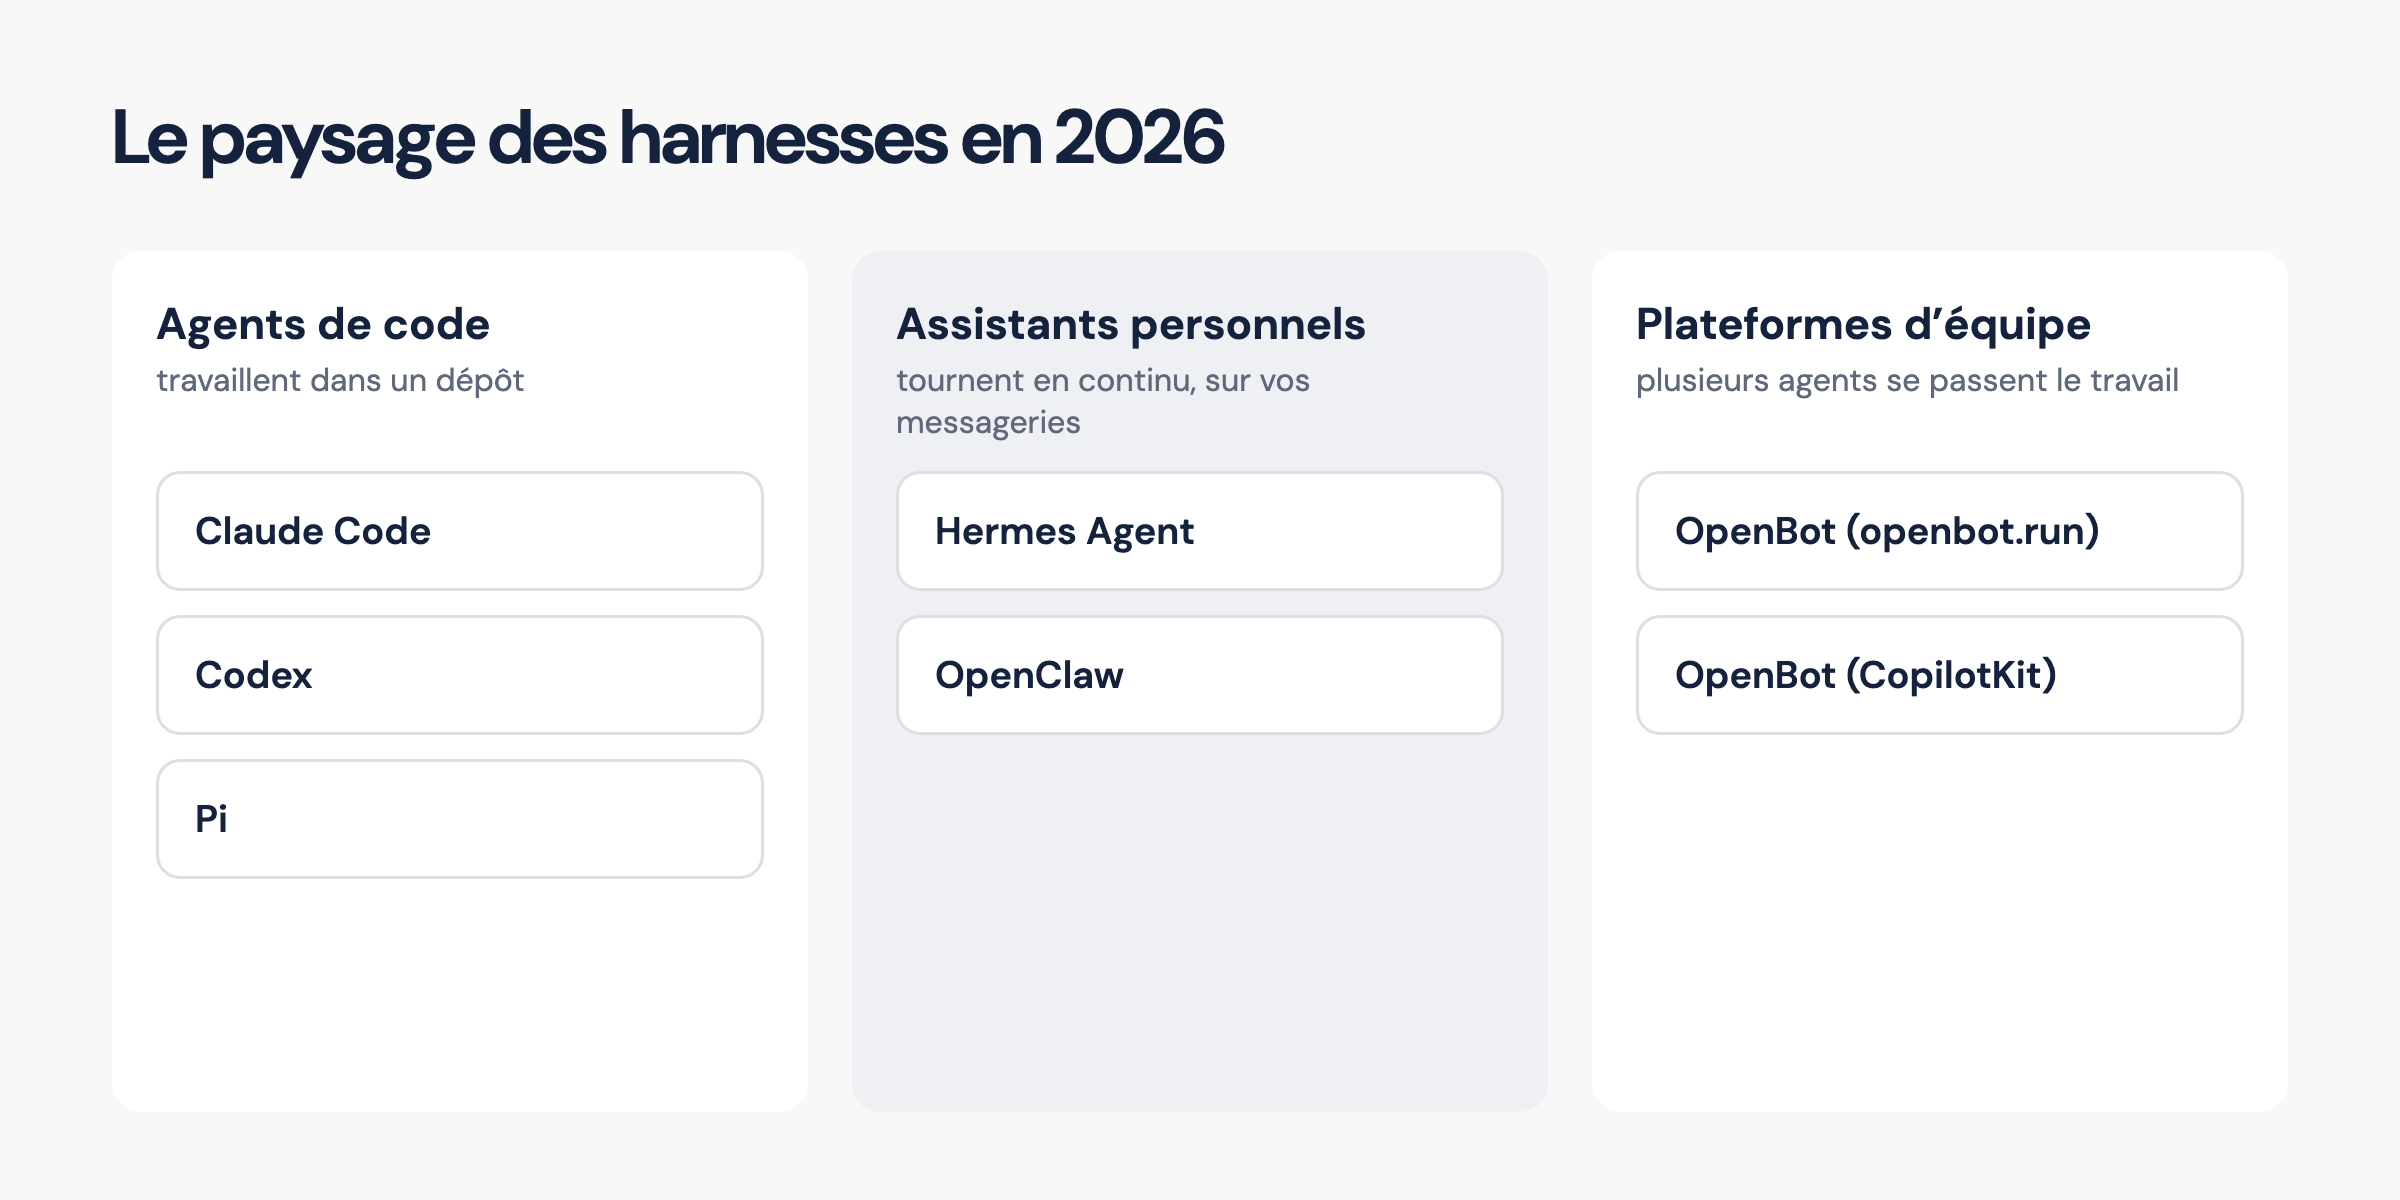
Les harnesses se rangent en trois familles. Les agents de code, qui travaillent dans un dépôt. Les assistants personnels, qui vivent dans vos messageries et tournent en continu. Les plateformes d’équipe, qui orchestrent plusieurs agents.
| Harness | Famille | Ce qui le distingue | Licence |
|---|---|---|---|
| Claude Code | Code | Couche d’extensions complète : CLAUDE.md, skills, MCP, sous-agents, hooks, plugins | Anthropic |
| Codex | Code | Harness open source qu’OpenAI expose aussi comme plateforme pour d’autres applications | Open source |
| Pi | Code | Harness minimal et extensible : pas de sous-agents ni de mode plan par défaut, on ajoute ce dont on a besoin | MIT |
| Hermes Agent | Assistant personnel | Boucle d’apprentissage : il crée des skills à partir de l’expérience et les améliore à l’usage. Un seul processus pour Telegram, Discord, Slack, WhatsApp, Signal et le terminal | MIT (Nous Research) |
| OpenClaw | Assistant personnel | Le plus populaire : plus de 380 000 étoiles sur GitHub au moment où j’écris. Tourne sur vos appareils, répond sur plus de vingt messageries | MIT |
| OpenBot (openbot.run) | Équipe | Des « coéquipiers » persistants sur votre ordinateur, qui se passent des tâches. Fait tourner Codex, Claude Code, Gemini, OpenCode ou Pi avec les abonnements que vous payez déjà | PolyForm Noncommercial (usage commercial sous licence séparée) |
| OpenBot (CopilotKit) | Équipe | Un assistant d’entreprise hébergé sur votre infrastructure, chaque agent avec son navigateur, ses fichiers et ses droits | MIT |
Attention au piège du nom : deux projets différents s’appellent OpenBot. Celui d’openbot.run est un logiciel de bureau, gratuit mais non commercial par défaut. Celui de CopilotKit est un projet sous licence MIT pensé pour les entreprises. Vérifiez lequel on vous recommande.
Quelques précisions utiles :
Hermes Agent suit le standard ouvert agentskills.io pour ses skills, chargées seulement quand elles servent pour économiser le contexte. C’est celui que j’utilise au quotidien : mes procédures (publication d’un article, contrôle d’un chiffre avant envoi à un client) y sont écrites une fois, puis réutilisées.
OpenClaw a changé deux fois de nom en janvier 2026 (Clawdbot, puis Moltbot, puis OpenClaw). Son créateur, Peter Steinberger, a rejoint OpenAI en février, et le projet est passé sous la tutelle d’une fondation, d’après Wikipédia.
La sécurité est un vrai sujet pour les assistants personnels, qui ont accès à un terminal et à vos messageries. La documentation d’OpenClaw publie une comparaison avec Hermes qui recense des signalements de sécurité côté Hermes. C’est un concurrent qui écrit : à lire comme une liste de points à vérifier, pas comme un verdict. OpenBot (openbot.run) prévient lui-même que ses agents peuvent modifier des fichiers et lancer des commandes sans demander à chaque fois.
Comment choisir un bon harness
Mon avis tranché : ne choisissez pas un harness sur un classement. Les études montrent que le meilleur couple change selon la tâche. Choisissez sur votre usage, puis testez.
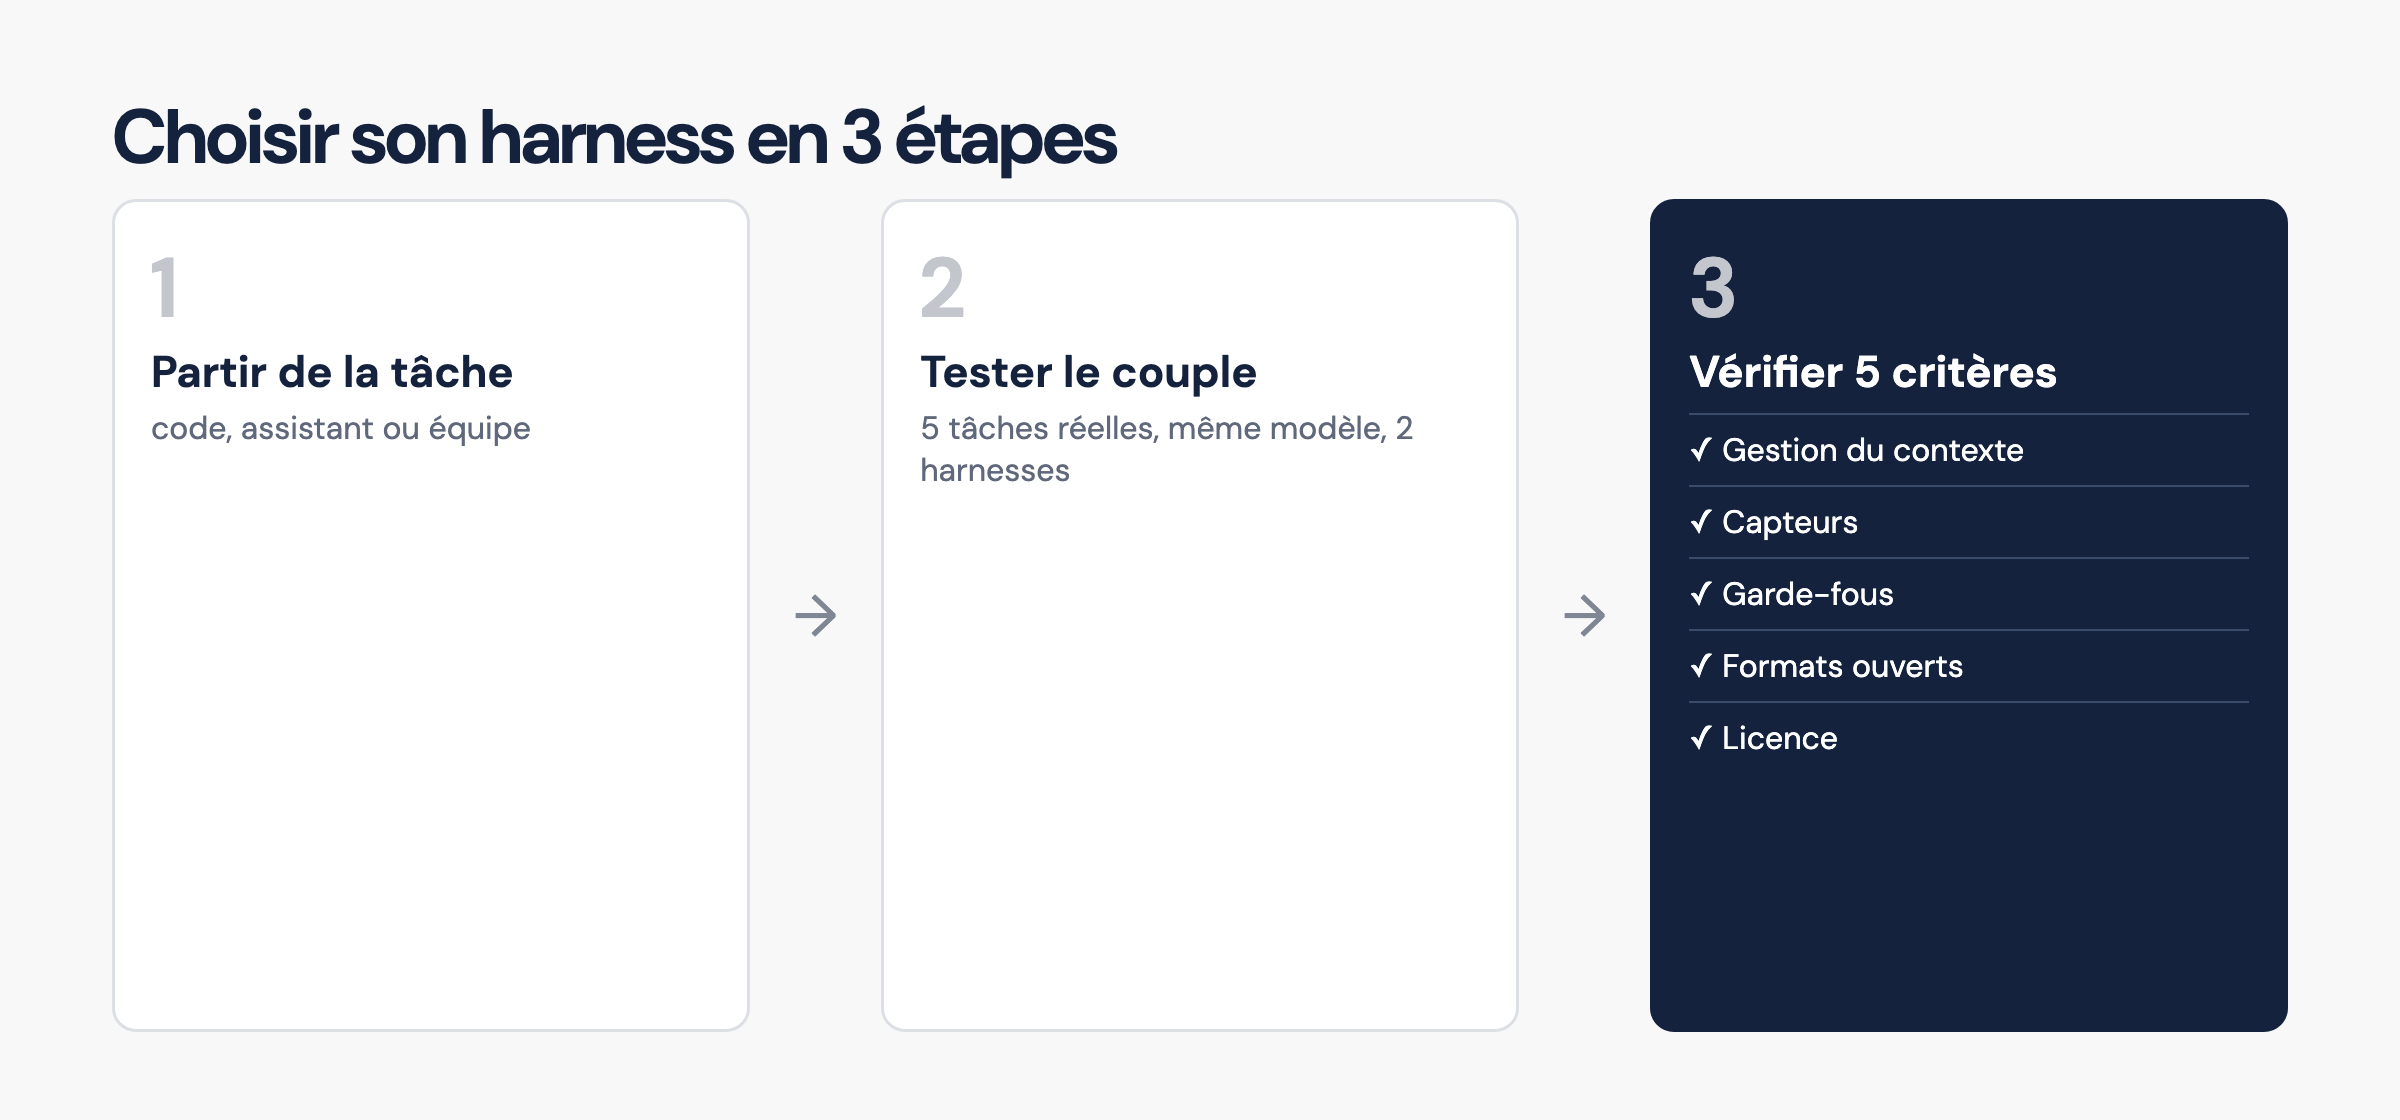
Partir de la tâche. Du code dans un dépôt : Claude Code, Codex ou Pi. Un assistant qui tourne en continu et vous répond sur Telegram : Hermes ou OpenClaw. Plusieurs agents qui se passent le travail : OpenBot.
Tester le couple modèle et harness sur vos tâches. Prenez cinq tâches réelles, faites-les tourner dans deux harnesses avec le même modèle, comparez le résultat et le coût. C’est la seule mesure qui compte pour vous.
Regarder la gestion du contexte. Le harness résume-t-il proprement une longue session ? Charge-t-il les consignes à la demande ou tout d’un coup ? C’est là que se jouent la qualité sur les tâches longues et la facture.
Vérifier les capteurs. Peut-on brancher des tests, des contrôles, une relecture automatique ? Un harness sans boucle de vérification vous laisse tout relire.
Exiger des garde-fous. Demande d’approbation avant les actions sensibles, bac à sable, droits par outil. Plus l’agent a d’accès (email, site, compte client), plus c’est critique.
Privilégier les formats ouverts. Consignes en
AGENTS.md, skills au format agentskills.io, outils via MCP : votre savoir-faire reste portable si vous changez de harness.Lire la licence. MIT, propriétaire ou non commerciale : pour un usage client, ça change tout.
Un harness bien ficelé peut-il améliorer le SEO ?
Réponse courte : pas directement, mais oui par trois chemins, dont un qui peut aussi vous faire du tort.
1. Il rend le travail SEO plus régulier et mieux sourcé
Google ne voit pas votre harness. Il voit vos pages. Le harness agit en amont, sur la qualité du travail. Semrush décrit le SEO agentique comme le fait de confier un processus SEO défini à un agent qui récupère ses propres données, suit une méthode documentée et rend la même analyse à chaque passage. Leur montage tient en quatre couches : un projet qui porte le contexte de l’entreprise, des skills qui portent la méthode, des connecteurs MCP qui ramènent des données à jour, et un prompt qui ne porte que la tâche du moment.
C’est exactement le vocabulaire du harness. Un agent qui lit vos vraies données Search Console, applique la même grille d’audit chaque mois et vérifie ses chiffres avant de les livrer fait un meilleur travail qu’un chat à qui l’on colle un export. Le gain SEO vient de là : moins d’erreurs, plus de régularité, plus de temps pour les décisions.
2. Il peut aussi produire du contenu de masse, et c’est un risque
Un harness rend très facile la production de centaines de pages. Google est explicite : générer de nombreuses pages avec l’IA sans apporter de valeur aux utilisateurs peut enfreindre sa règle contre l’abus de contenu à grande échelle, et les sites qui enfreignent ses règles anti-spam peuvent être moins bien classés ou disparaître des résultats. Un bon harness se règle aussi pour dire non : relecture humaine, contrôle des sources, pas de page créée pour un seul mot-clé.
3. Les harnesses sont aussi vos nouveaux visiteurs
C’est le point le plus sous-estimé. Quand ChatGPT, Claude ou un agent de navigation répond à une question, c’est un harness qui va chercher et lire vos pages. Vercel et le laboratoire ora.ai ont observé 1 033 sessions d’agents sur 25 sites entre juin et août 2026 :
Sur 1 023 réponses dont l’origine a pu être tracée, 844, soit 82,5 %, venaient d’une page effectivement récupérée.
Dans leurs tests contrôlés, une réponse cachée derrière du JavaScript n’était pas récupérée par un client qui se contente de télécharger la page. Une erreur
403bloquait les deux clients testés.
Leurs résultats décrivent leur échantillon, pas le web entier, et ils le précisent. Mais la leçon pour le GEO est nette : une page lisible en HTML et accessible sans blocage a plus de chances d’être citée par un agent. Le SEO technique de base devient la condition pour exister dans les réponses des agents.
Ce que je ferais à votre place
Choisir un harness et s’y tenir trois semaines sur des tâches SEO réelles : audit mensuel, suivi de positions, contrôle technique.
Écrire vos méthodes en skills plutôt qu’en prompts copiés-collés : une skill par processus, avec ses règles et ses contrôles.
Brancher vos données (Search Console, Analytics, crawler) via MCP, pour que l’agent travaille sur du réel.
Ajouter un capteur à chaque livrable : un chiffre se vérifie dans sa source avant de partir.
Tester vos pages comme un agent les voit : récupérez-les sans JavaScript et vérifiez que la réponse est dans le HTML.
En résumé
Le harness, c’est la moitié de l’agent dont personne ne parlait il y a un an. Les mesures de 2026 montrent qu’il peut faire varier un résultat de plusieurs dizaines de points avec le même modèle. Pour le choisir, partez de votre tâche, testez sur vos propres cas et gardez vos méthodes dans des formats ouverts.
Pour le SEO, il n’y a pas de raccourci : un harness ne fait pas ranker un site. Il rend le travail plus fiable, il peut aussi industrialiser du contenu sans valeur, et il est désormais le visiteur qui décide si vos pages seront citées. C’est sur ces trois terrains qu’il se joue.