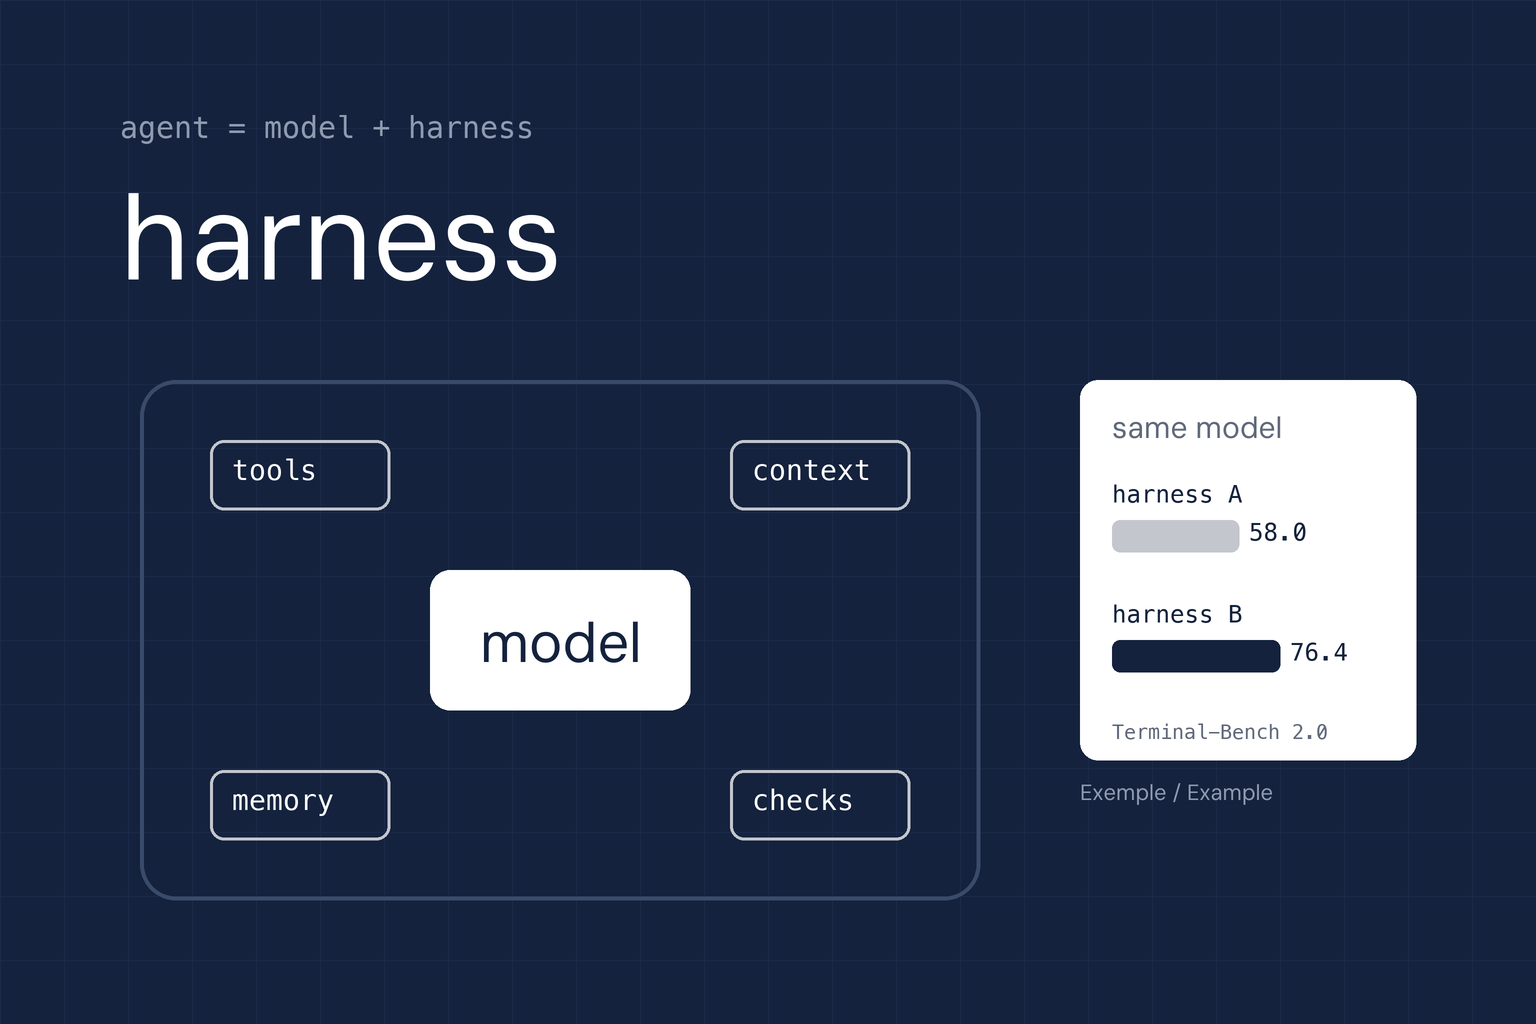
Wenn man KI-Agenten vergleicht, vergleicht man fast immer Modelle: Claude gegen GPT, GPT gegen Gemini. Das ist, als würde man den Motor betrachten und das Auto vergessen.
Seit Anfang 2026 hat sich bei denen, die diese Agenten bauen, ein Wort durchgesetzt: der Harness. Er ist alles, was das Modell umgibt und ihm das Handeln ermöglicht. Und die in diesem Jahr veröffentlichten Messungen zeigen, dass er für das Ergebnis mindestens so viel Gewicht hat wie das Modell.
Ich nutze täglich einen Harness für meine SEO- und GEO-Arbeit. Hier steht, was ich aus den Quellen mitgenommen habe, wie ich heute auswählen würde und wie die ehrliche Antwort auf die Frage lautet, die alle stellen: Verbessert das SEO?
Das Wichtigste
Ein Harness ist der ganze Agent außer dem Modell: die Werkzeuge, die Kontextverwaltung, das Gedächtnis, die Sicherheitsregeln, die Verifikationsschleifen. LangChain fasst es in einer Formel zusammen: Agent = Model + Harness.
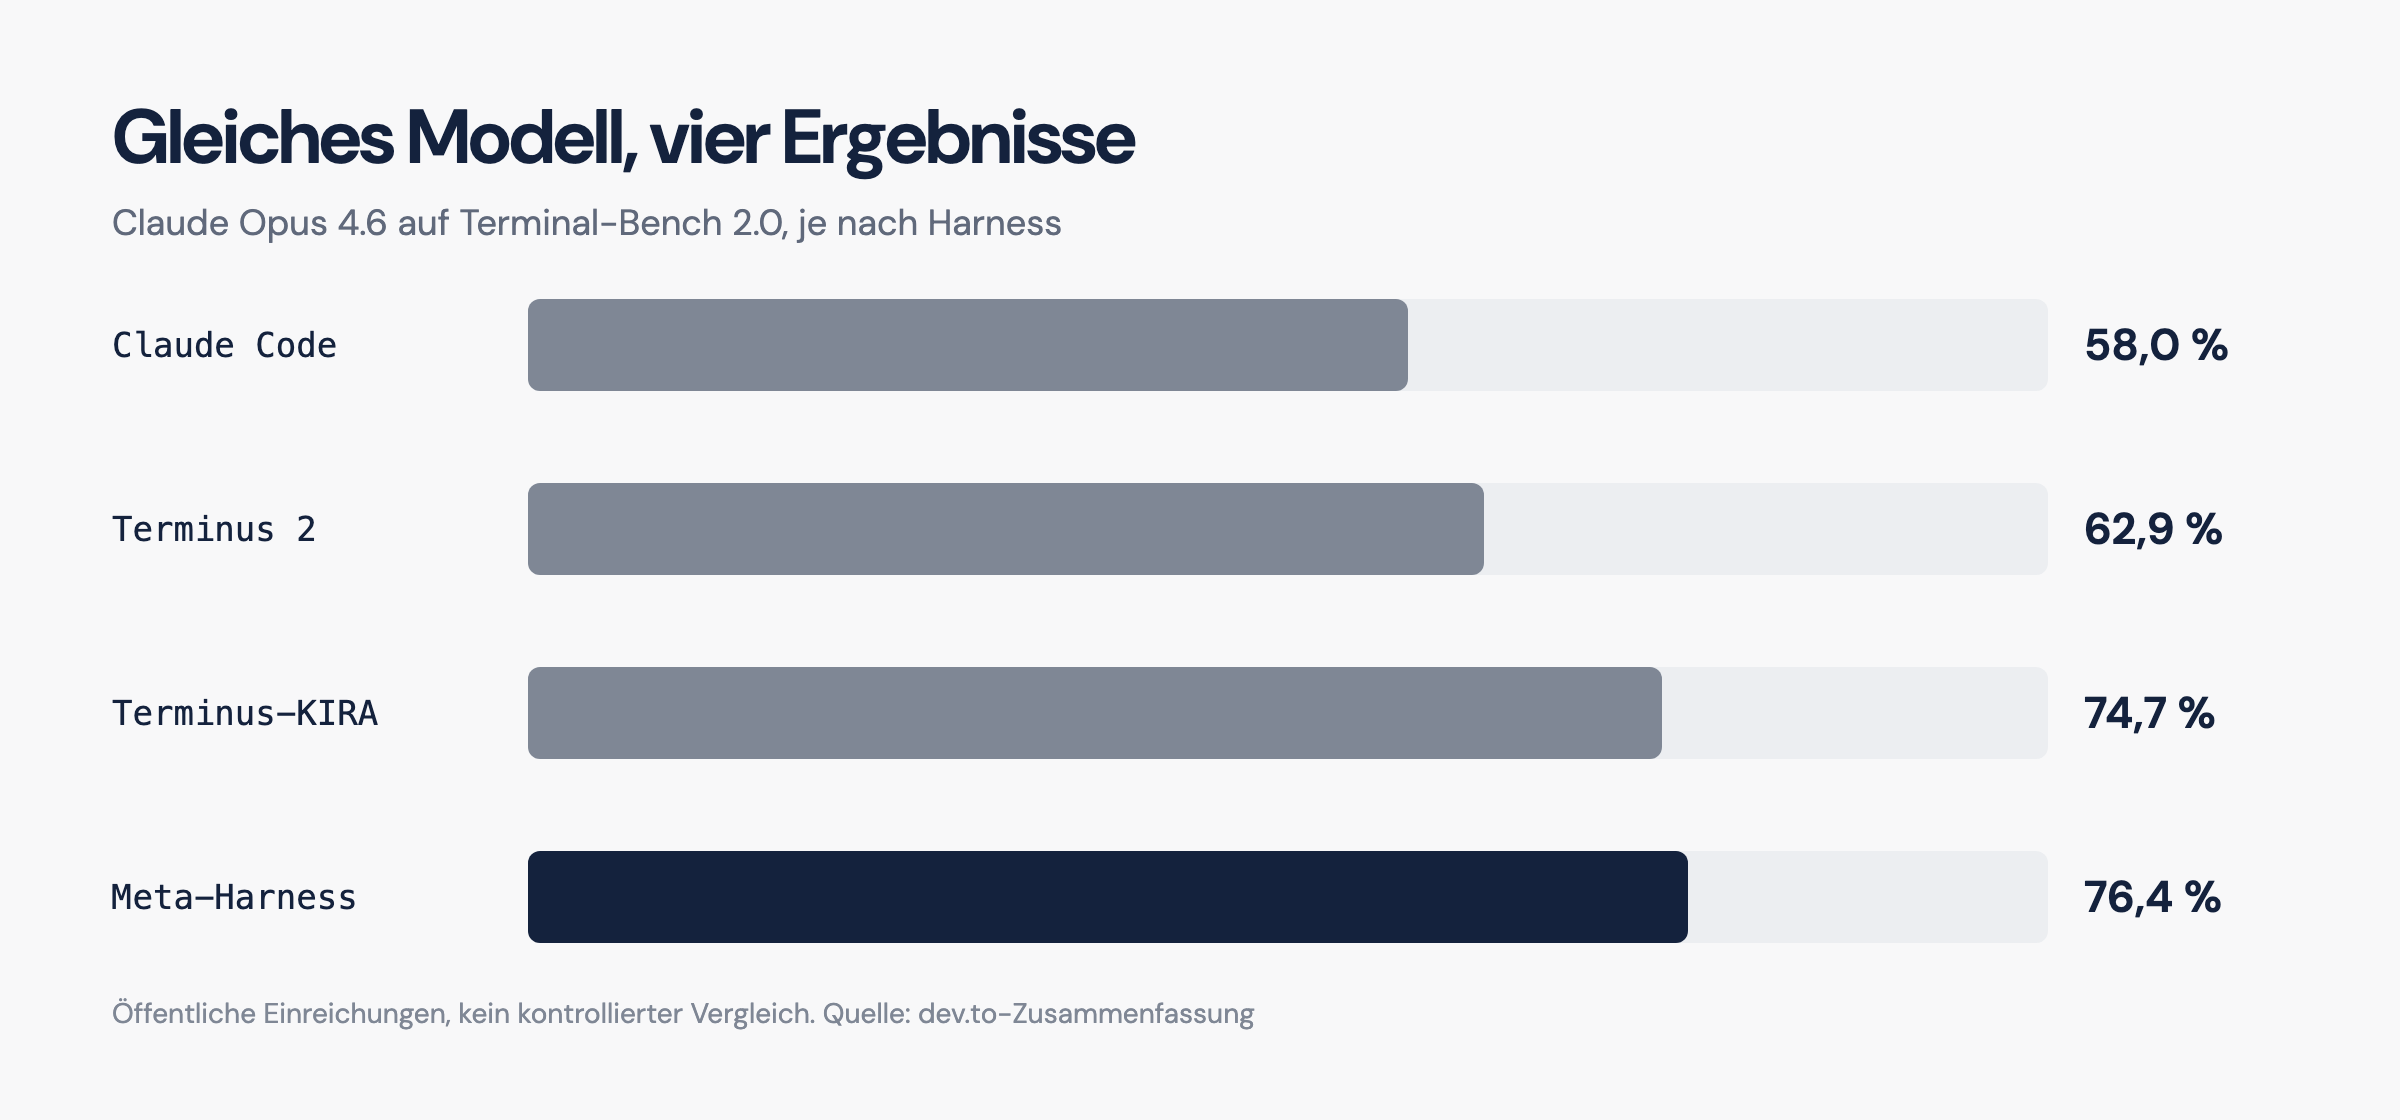
Im selben Benchmark steigt das gleiche Modell je nach Harness von 58,0 % auf 76,4 %, laut den aus Terminal-Bench 2.0 übernommenen Zahlen. Die Autoren weisen darauf hin, dass es sich nicht um ein kontrolliertes Experiment handelt.
Eine Studie vom Oktober 2026 mit 66 Konfigurationen zeigt, dass sich die Rangfolge der Modelle von einem Harness zum anderen umkehrt und dass der Harness des Herstellers nicht immer der beste für das eigene Modell ist.
Den besten Harness im Absoluten gibt es nicht. Es gibt ein gutes Paar aus Modell und Harness für eine bestimmte Aufgabe, und das lässt sich testen.
Ein Harness lässt eine Website nicht ranken. Er verändert die Qualität und die Regelmäßigkeit der SEO-Arbeit, und er kann auch Massencontent erzeugen, den Google abstraft. Die Wirkung hängt davon ab, was man ihn tun lässt.
Was ist ein Harness?
Das Wort stammt aus der Ausrüstung: das Geschirr, das das Pferd mit dem Pflug verbindet. Das Pferd liefert die Kraft, das Geschirr macht sie nutzbar. Auf KI-Agenten übertragen, trägt das Bild gut.
LangChain liefert die meistzitierte Definition: „Agent = Model + Harness“. Das Modell enthält die Intelligenz, der Harness ist das System, das sie nutzbar macht. Martin Fowler greift denselben Gedanken auf: Der Begriff bezeichne alles in einem Agenten außer dem Modell selbst.
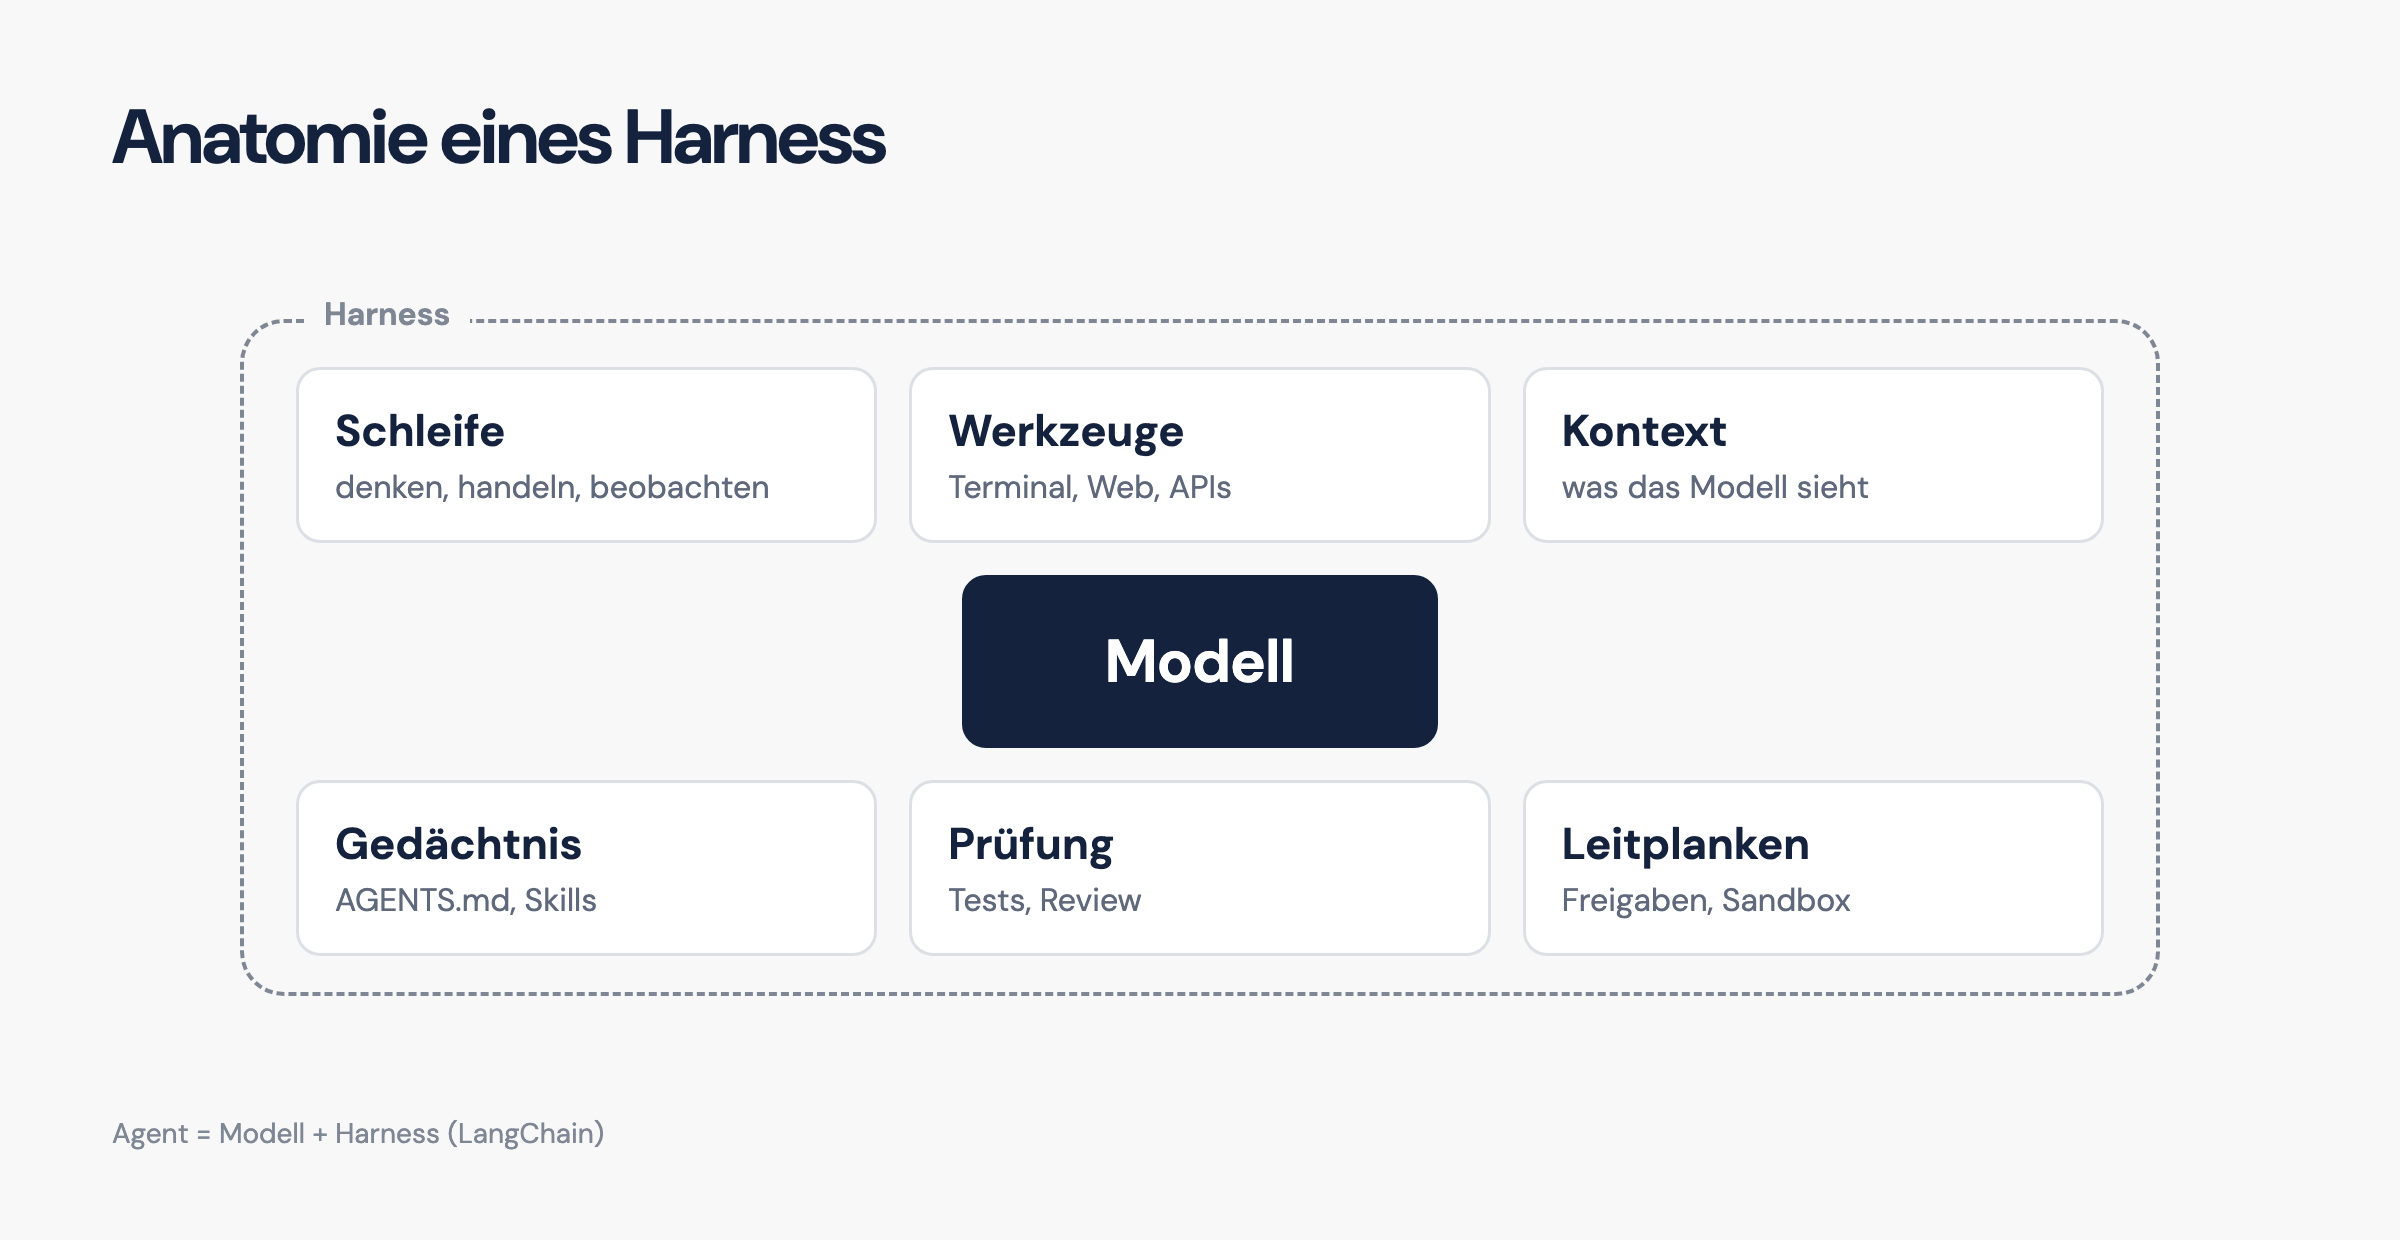
Konkret erhält ein Modell allein Text und gibt Text zurück. Es liest Ihre Dateien nicht, öffnet keinen Browser und erinnert sich von einer Sitzung zur nächsten an nichts. Das alles übernimmt der Harness:
| Baustein | Was er leistet | Beispiel |
|---|---|---|
| Agentenschleife | Lässt das Modell laufen: Es denkt nach, ruft ein Werkzeug auf, liest das Ergebnis und beginnt von vorn | Der Kern von Claude Code, Codex oder Hermes |
| Werkzeuge | Gibt dem Modell Hände: Terminal, Dateien, Websuche, Browser | Ein bash-Zugang, eine Search-Console-API |
| Kontext | Entscheidet, was das Modell in jeder Runde sieht, und fasst zusammen, was überläuft | Kompaktierung einer langen Sitzung |
| Gedächtnis und Anweisungen | Bewahrt Regeln und Erkenntnisse von einer Sitzung zur nächsten auf | AGENTS.md, CLAUDE.md, Skills |
| Verifikation | Prüft die Arbeit, bevor sie beim Menschen ankommt | Tests, Linter, Gegenlesen durch einen zweiten Agenten |
| Leitplanken | Sandbox, Freigabeabfragen, eingeschränkte Rechte | Bestätigung vor jedem Löschen |
OpenAI beschreibt den Harness von Codex in denselben Begriffen: Er hilft dem Modell, Kontext zu sammeln, Werkzeuge zu nutzen, innerhalb der konfigurierten Grenzen zu bleiben, eine Freigabe einzuholen und die Arbeit fortzusetzen, und zwar von Runde zu Runde.
Woher der Begriff „Harness Engineering“ kommt
Der Begriff setzte sich im ersten Halbjahr 2026 durch. Am 5. Februar veröffentlicht Mitchell Hashimoto, Mitgründer von HashiCorp, seinen Weg zur KI-Nutzung, in dem ein Abschnitt „Engineer the Harness“ heißt. Seine Methode ist einfach: Jedes Mal, wenn sich der Agent bei einem Befehl oder einer API irrt, fügt er der Datei AGENTS.md des Projekts eine Zeile hinzu. Jede Zeile entspricht einem beobachteten Fehler.
OpenAI veröffentlichte anschließend seinen eigenen Erfahrungsbericht unter dem Titel „Harness engineering“. Die Lehre, die ich am nützlichsten finde: Geben Sie dem Agenten eine Karte, kein Handbuch mit 1.000 Seiten. Kontext ist eine knappe Ressource. Eine riesige Anweisungsdatei erdrückt die Aufgabe, und wenn alles „wichtig“ ist, ist nichts mehr wichtig.
Anthropic wiederum hat dokumentiert, wie man einen Agenten über mehrere Sitzungen hinweg arbeiten lässt. Ihr Harness trennt einen Initialisierungsagenten, der die Umgebung vorbereitet, von einem Agenten, der in kleinen Schritten vorankommt. Drei Dateien dienen als roter Faden: eine Funktionsliste in JSON, die der Agent nur abhaken darf, eine Fortschrittsdatei und die Git-Historie. Das Problem, das sie damit beheben, ist sehr aufschlussreich: Ohne diesen Rahmen erklärt der Agent das Projekt zu früh für abgeschlossen.
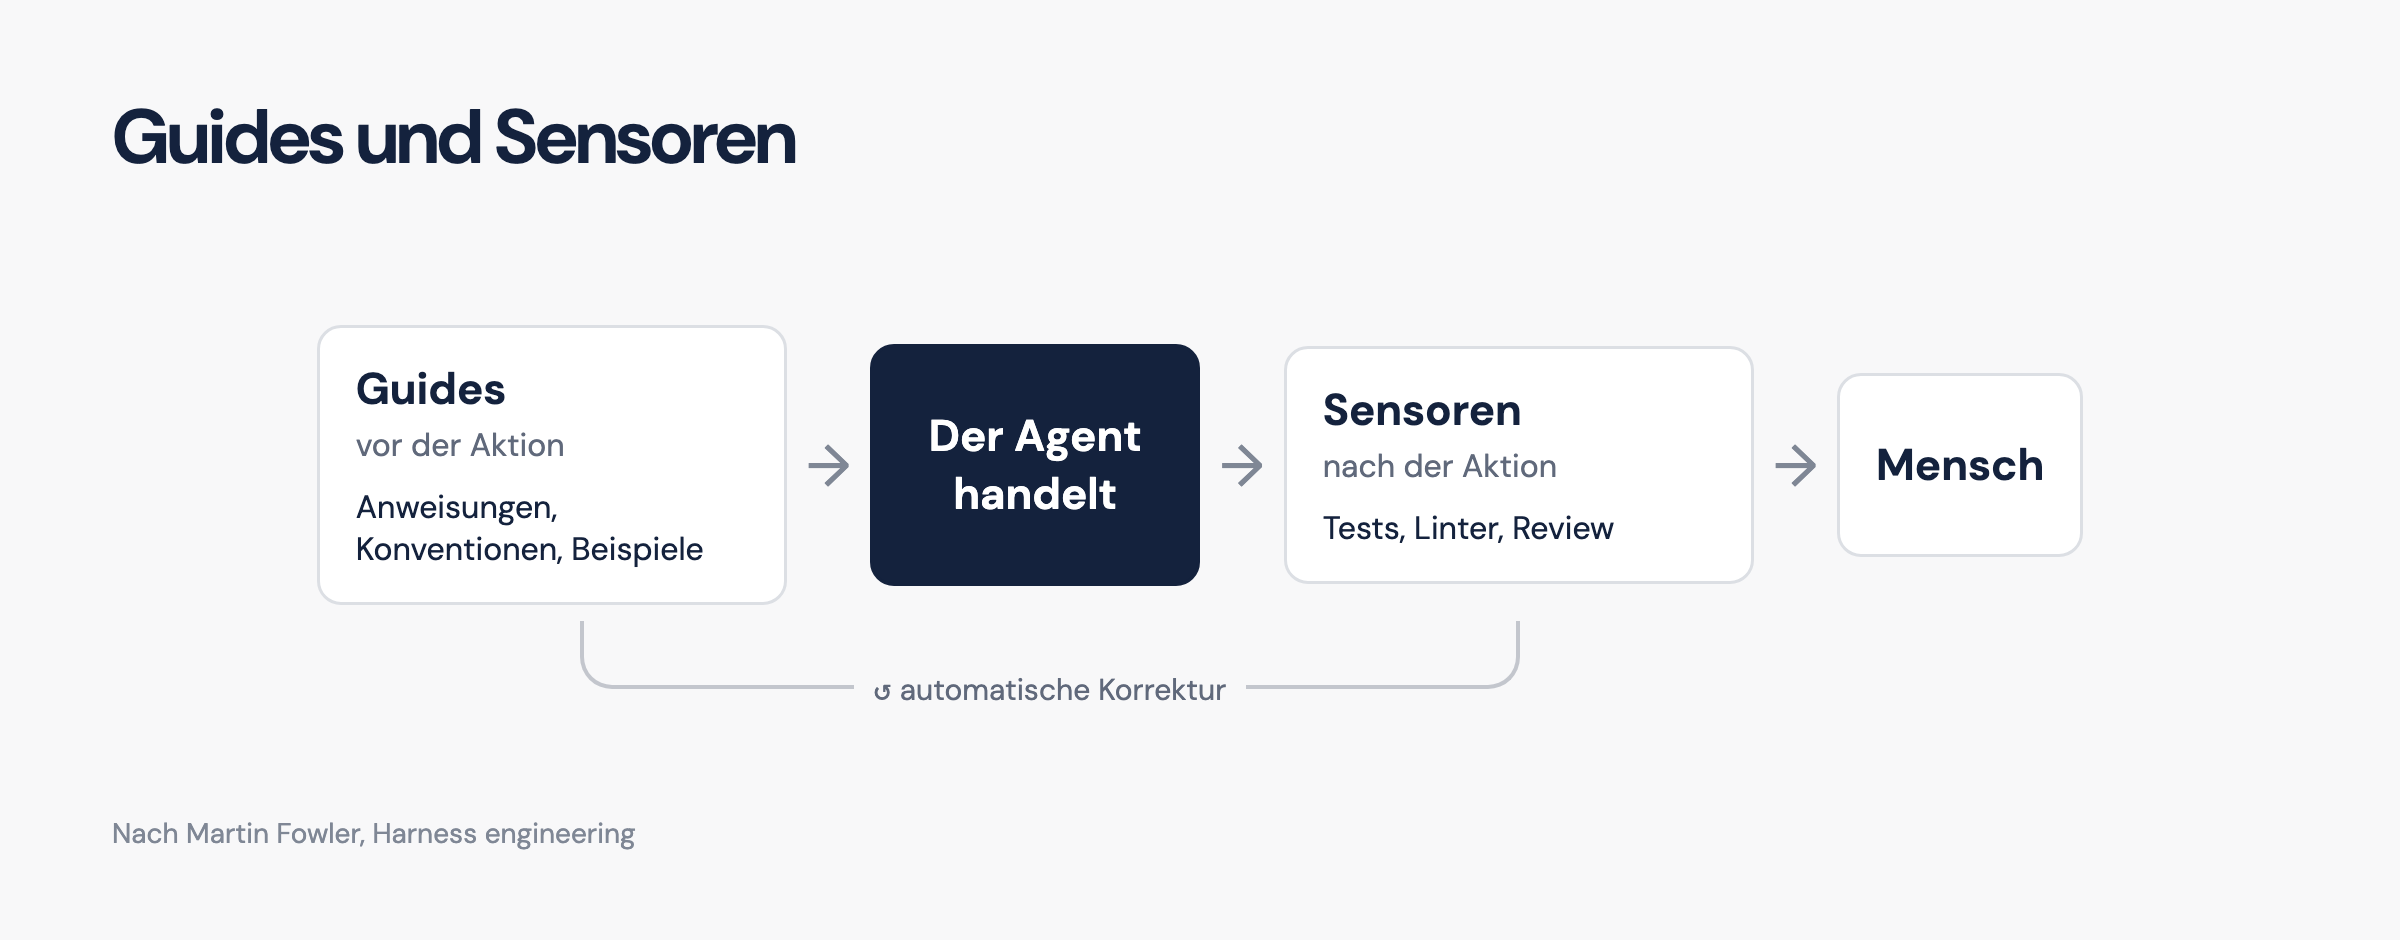
Martin Fowler bietet das klarste Raster, um das alles zu durchdenken. Ein Harness hat zwei Arten von Kontrollen: die Guides, die den Agenten ausrichten, bevor er handelt (Anweisungen, Konventionen, Beispiele), und die Sensoren, die im Nachhinein beobachten und ihm helfen, sich zu korrigieren (Tests, Linter, Gegenlesen). Ein guter Harness erhöht die Chance, es gleich beim ersten Mal richtig zu machen, und fängt möglichst viele Fehler ab, bevor ein Mensch sie sieht.
Der Harness wiegt so viel wie das Modell
Dieser Teil sollte ändern, wie man seine Werkzeuge auswählt. Mehrere 2026 veröffentlichte Messungen weisen in dieselbe Richtung.
| Messung | Gleiches Modell, Ergebnisse je nach Harness | Quelle |
|---|---|---|
| Terminal-Bench 2.0, Claude Opus 4.6 | 58,0 % mit Claude Code, 62,9 % mit Terminus 2, 74,7 % mit Terminus-KIRA, 76,4 % mit Meta-Harness | Zusammenfassung auf dev.to einer Forschungsarbeit |
| Terminal-Bench 2.1, GLM-5.2 | 59,8 % mit OpenCode, 65,4 % mit Claude Code, 69,0 % mit Cursor, 72,6 % mit Kimchi | von Kimchi veröffentlichter Test |
| ARC-AGI-3, GPT-5.6 Sol | von 13,3 % auf 38,3 %, indem das Reasoning erhalten und der Kontext kompaktiert wird, bei sechsmal weniger Output-Tokens | OpenAI |
Die solideste Studie, die ich gefunden habe, stammt von der Nanyang Technological University und wurde am 1. Oktober 2026 veröffentlicht. Die Autoren haben 66 Konfigurationen getestet: vier konfigurierbare Harnesses (OpenHands, DeepSeek Harness, Pi, openJiuwen) mit fünf Modellen auf drei Benchmarks, dazu die nativen Paare Codex mit GPT und Claude Code mit Claude. Ihre Schlussfolgerungen:
Die Rangfolge der Modelle kehrt sich je nach Harness um. Auf Terminal-Bench 4 liegt Claude in OpenHands um 7,94 Punkte vor GPT, in Pi dagegen um 30,16 Punkte dahinter.
Der Harness des Herstellers ist nicht immer der beste für das eigene Modell.
Mehr zu bezahlen garantiert kein besseres Ergebnis. Auf Terminal-Bench 4 schneidet GPT unter Pi besser ab als unter DeepSeek Harness, bei weniger als einem Viertel der Kosten pro Aufgabe.
Den Unterschied macht die Art, wie der Harness Fehlschläge in einer Form an das Modell zurückgibt, mit der es etwas anfangen kann.
Ein Positionspapier geht weiter und spricht von einer „limitierenden Randbedingung“: Bei langen Aufgaben und zwischen Modellen auf vergleichbarem Niveau erkläre die Konfiguration des Harness die Streuung der Ergebnisse stärker als die Wahl des Modells. Die Bewertungsprotokolle würden dem Modell also Gewinne zuschreiben, die vom Harness stammen.
Die Grenzen dieser Zahlen
Das sind nicht meine Messungen. Ich habe keinen dieser Tests reproduziert. Die Zahlen stammen von den Autoren.
Die öffentlichen Vergleiche sind nicht kontrolliert. Der Abstand von 18 Punkten bei Claude Opus 4.6 vergleicht Einreichungen, die sich in Prompts, Versionen und Token-Budgets unterscheiden können. Die Autoren sagen das selbst, und ein Teil des Ergebnisses von Claude Code stammte aus defekten Aufgaben, die in Version 2.1 des Benchmarks korrigiert wurden.
Kimchi ist Richter und Partei zugleich. Der eigene Test setzt den eigenen Harness an die Spitze. Interessant bleibt das Ergebnis wegen des Abstands von 13 Punkten, nicht wegen des Siegertreppchens.
Es gibt eine Gegenmeinung. Laut der Zusammenfassung von The Deep Feed halten die Autoren von Terminal-Bench die Wahl des Modells im Allgemeinen für wichtiger als den Harness. Die Debatte ist nicht entschieden.
Code-Benchmarks sind keine SEO-Aufgaben. Keiner dieser Tests misst ein Audit, eine Keyword-Analyse oder das Schreiben von Texten.
Solide bleibt die Richtung: Dasselbe Modell liefert in zwei verschiedenen Harnesses nicht dasselbe Ergebnis. Man kann sein Werkzeug nicht mehr allein nach dem Namen des Modells auswählen.
Die Landschaft 2026: Hermes, OpenClaw, OpenBot und die anderen
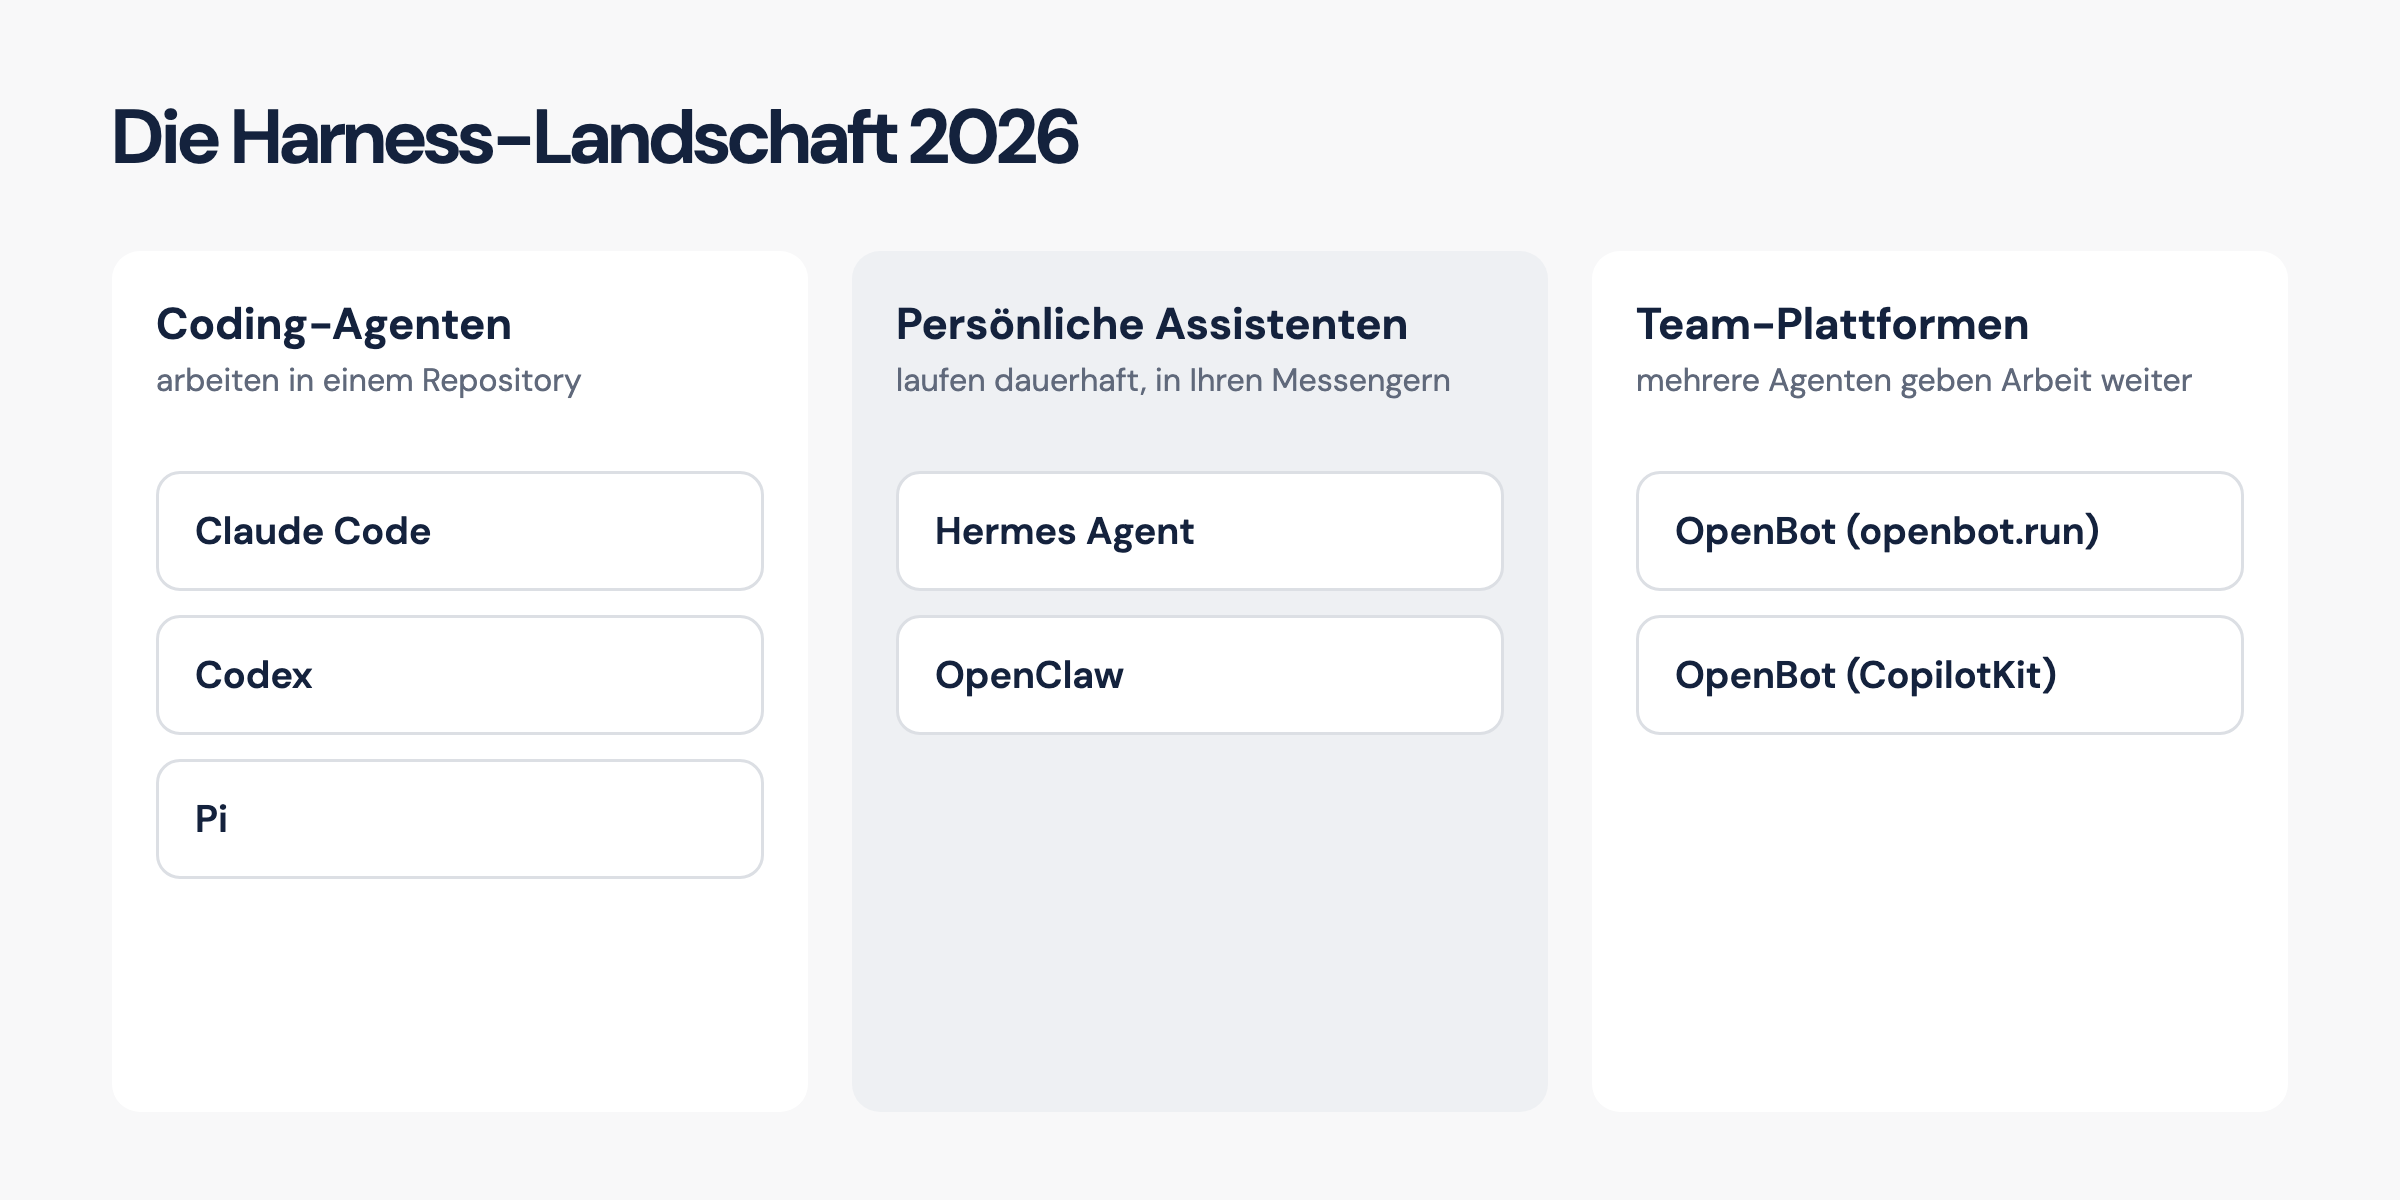
Die Harnesses lassen sich in drei Familien einteilen. Die Code-Agenten, die in einem Repository arbeiten. Die persönlichen Assistenten, die in Ihren Messengern leben und dauerhaft laufen. Die Team-Plattformen, die mehrere Agenten orchestrieren.
| Harness | Familie | Was ihn auszeichnet | Lizenz |
|---|---|---|---|
| Claude Code | Code | Vollständige Erweiterungsschicht: CLAUDE.md, Skills, MCP, Subagenten, Hooks, Plugins | Anthropic |
| Codex | Code | Open-Source-Harness, den OpenAI auch als Plattform für andere Anwendungen bereitstellt | Open Source |
| Pi | Code | Minimaler und erweiterbarer Harness: standardmäßig keine Subagenten und kein Planmodus, man ergänzt, was man braucht | MIT |
| Hermes Agent | Persönlicher Assistent | Lernschleife: Er erstellt Skills aus Erfahrung und verbessert sie im Gebrauch. Ein einziger Prozess für Telegram, Discord, Slack, WhatsApp, Signal und das Terminal | MIT (Nous Research) |
| OpenClaw | Persönlicher Assistent | Der beliebteste: über 380.000 Sterne auf GitHub zum Zeitpunkt, an dem ich schreibe. Läuft auf Ihren Geräten, antwortet in mehr als zwanzig Messengern | MIT |
| OpenBot (openbot.run) | Team | Dauerhafte „Teamkollegen“ auf Ihrem Rechner, die sich Aufgaben zureichen. Lässt Codex, Claude Code, Gemini, OpenCode oder Pi mit den Abonnements laufen, die Sie ohnehin bezahlen | PolyForm Noncommercial (kommerzielle Nutzung über separate Lizenz) |
| OpenBot (CopilotKit) | Team | Ein Unternehmensassistent, gehostet auf Ihrer Infrastruktur, jeder Agent mit eigenem Browser, eigenen Dateien und eigenen Rechten | MIT |
Vorsicht vor der Namensfalle: Zwei verschiedene Projekte heißen OpenBot. Das von openbot.run ist eine Desktop-Software, kostenlos, aber standardmäßig nicht kommerziell. Das von CopilotKit ist ein Projekt unter MIT-Lizenz, gedacht für Unternehmen. Prüfen Sie, welches Ihnen empfohlen wird.
Einige nützliche Präzisierungen:
Hermes Agent folgt für seine Skills dem offenen Standard agentskills.io; sie werden nur geladen, wenn sie gebraucht werden, um Kontext zu sparen. Diesen nutze ich im Alltag: Meine Abläufe (einen Artikel veröffentlichen, eine Zahl vor dem Versand an einen Kunden prüfen) sind dort einmal beschrieben und werden dann wiederverwendet.
OpenClaw hat im Januar 2026 zweimal den Namen gewechselt (Clawdbot, dann Moltbot, dann OpenClaw). Sein Schöpfer Peter Steinberger ist im Februar zu OpenAI gewechselt, und das Projekt ging laut Wikipedia in die Obhut einer Stiftung über.
Sicherheit ist ein echtes Thema bei persönlichen Assistenten, die Zugriff auf ein Terminal und auf Ihre Messenger haben. Die Dokumentation von OpenClaw veröffentlicht einen Vergleich mit Hermes, der Sicherheitsmeldungen auf Seiten von Hermes auflistet. Hier schreibt ein Konkurrent: Lesen Sie es als Liste von Punkten zur Überprüfung, nicht als Urteil. OpenBot (openbot.run) warnt selbst, dass seine Agenten Dateien ändern und Befehle ausführen können, ohne jedes Mal nachzufragen.
Wie Sie einen guten Harness auswählen
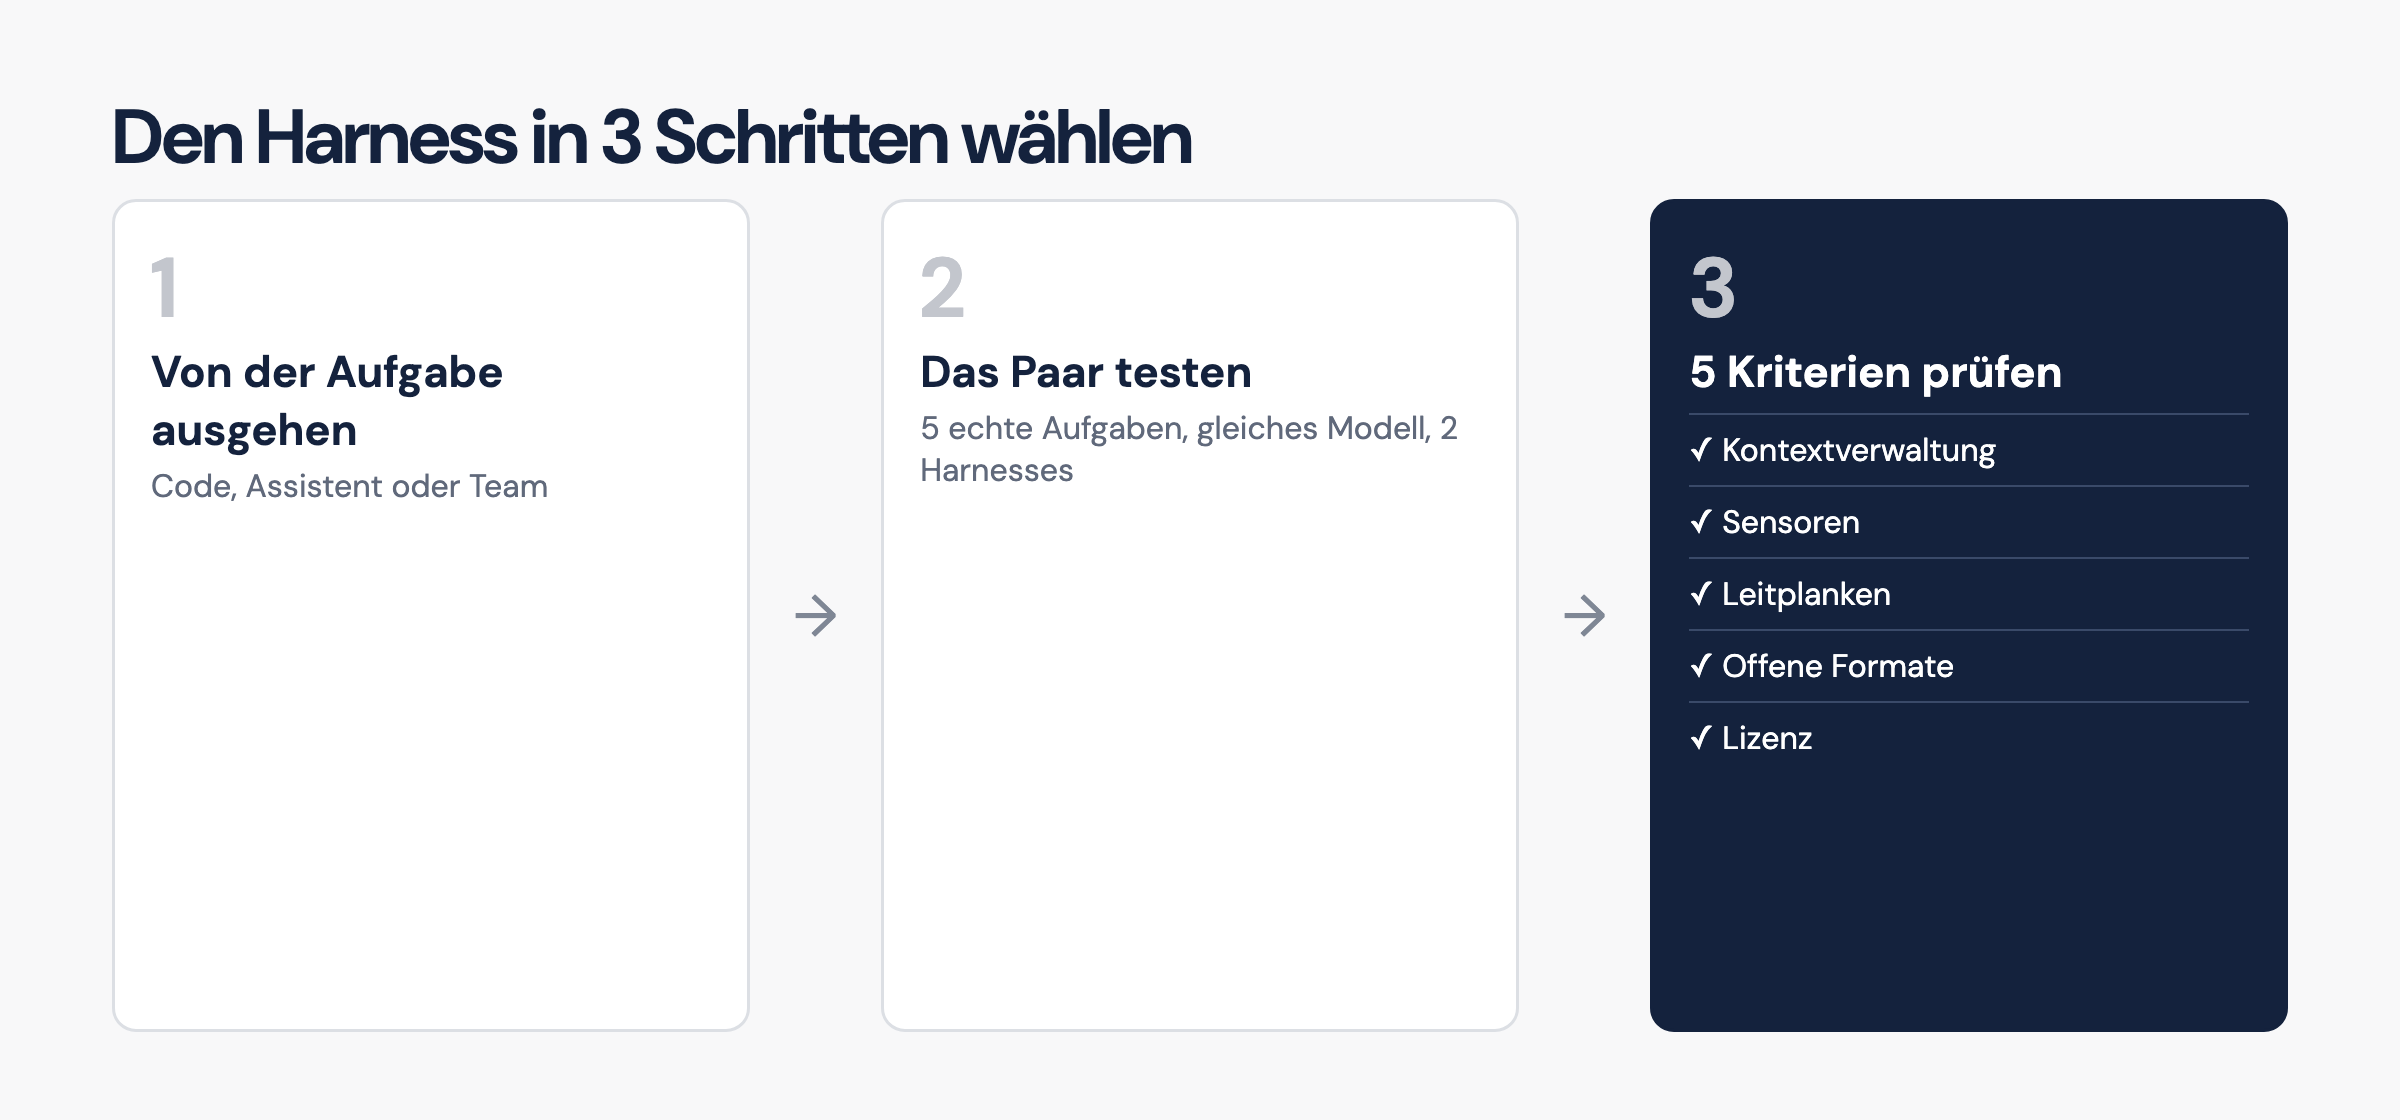
Meine klare Meinung: Wählen Sie einen Harness nicht nach einem Ranking aus. Die Studien zeigen, dass das beste Paar je nach Aufgabe wechselt. Wählen Sie nach Ihrem Einsatzzweck und testen Sie dann.
Von der Aufgabe ausgehen. Code in einem Repository: Claude Code, Codex oder Pi. Ein Assistent, der dauerhaft läuft und Ihnen auf Telegram antwortet: Hermes oder OpenClaw. Mehrere Agenten, die sich die Arbeit zureichen: OpenBot.
Das Paar aus Modell und Harness an Ihren Aufgaben testen. Nehmen Sie fünf reale Aufgaben, lassen Sie sie in zwei Harnesses mit demselben Modell laufen und vergleichen Sie Ergebnis und Kosten. Das ist die einzige Messung, die für Sie zählt.
Die Kontextverwaltung prüfen. Fasst der Harness eine lange Sitzung sauber zusammen? Lädt er die Anweisungen bei Bedarf oder alle auf einmal? Hier entscheiden sich die Qualität bei langen Aufgaben und die Rechnung.
Die Sensoren prüfen. Lassen sich Tests, Kontrollen, ein automatisches Gegenlesen anbinden? Ein Harness ohne Verifikationsschleife lässt Sie alles selbst nachlesen.
Leitplanken verlangen. Freigabeabfrage vor sensiblen Aktionen, Sandbox, Rechte pro Werkzeug. Je mehr Zugriff der Agent hat (E-Mail, Website, Kundenkonto), desto kritischer wird das.
Offene Formate bevorzugen. Anweisungen in
AGENTS.md, Skills im Format agentskills.io, Werkzeuge über MCP: Ihr Know-how bleibt portabel, falls Sie den Harness wechseln.Die Lizenz lesen. MIT, proprietär oder nicht kommerziell: Für den Einsatz bei Kunden macht das den entscheidenden Unterschied.
Kann ein gut gebauter Harness das SEO verbessern?
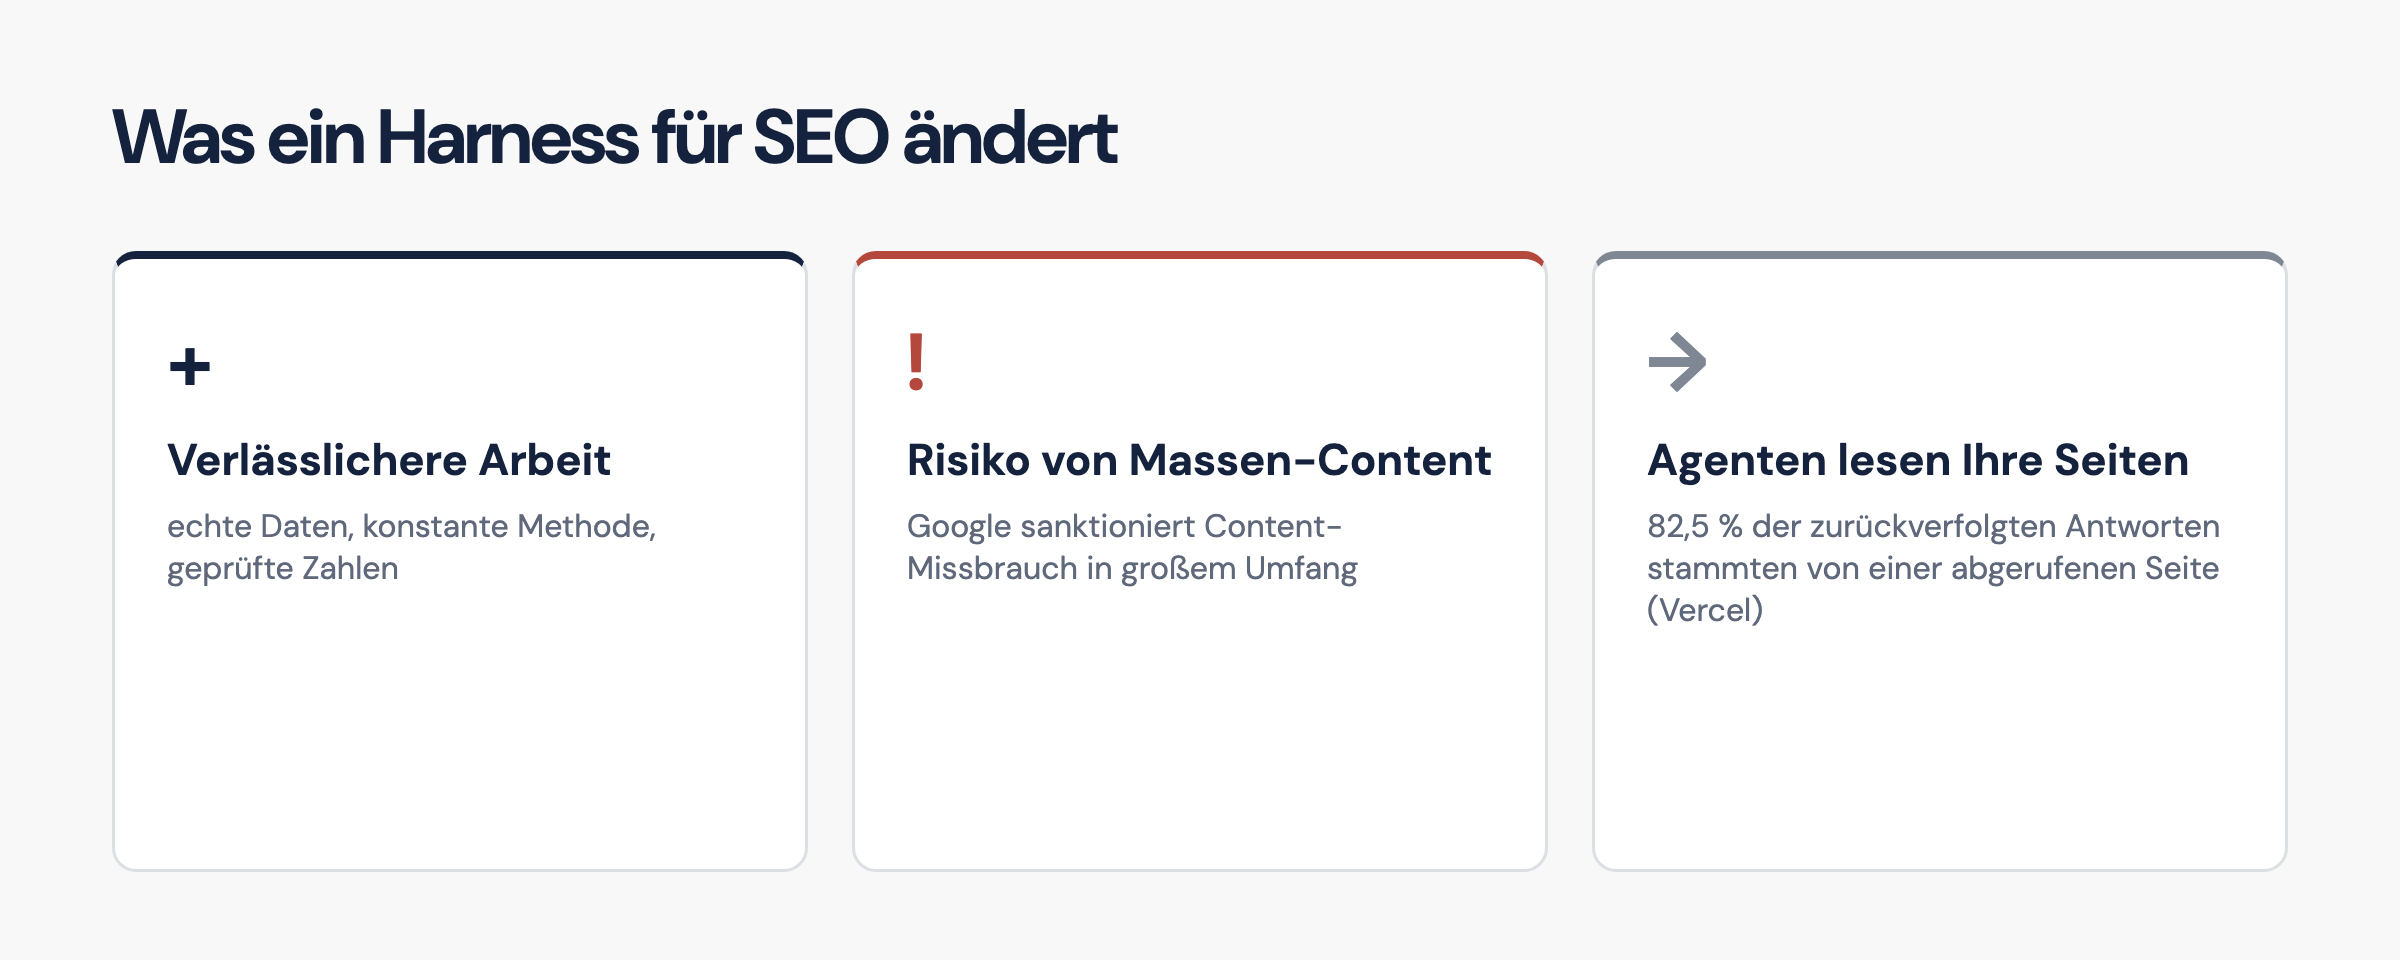
Kurze Antwort: nicht direkt, aber ja, auf drei Wegen, von denen einer Ihnen auch schaden kann.
1. Er macht die SEO-Arbeit regelmäßiger und besser belegt
Google sieht Ihren Harness nicht. Es sieht Ihre Seiten. Der Harness wirkt vorgelagert, auf die Qualität der Arbeit. Semrush beschreibt agentisches SEO als das Übertragen eines definierten SEO-Prozesses an einen Agenten, der seine Daten selbst abruft, einer dokumentierten Methode folgt und bei jedem Durchlauf dieselbe Analyse liefert. Ihr Aufbau besteht aus vier Schichten: ein Projekt, das den Unternehmenskontext trägt, Skills, die die Methode tragen, MCP-Konnektoren, die aktuelle Daten liefern, und ein Prompt, der nur die Aufgabe des Moments enthält.
Das ist genau das Vokabular des Harness. Ein Agent, der Ihre echten Search-Console-Daten liest, jeden Monat dasselbe Audit-Raster anwendet und seine Zahlen vor der Lieferung prüft, leistet bessere Arbeit als ein Chat, in den man einen Export hineinkopiert. Der SEO-Gewinn kommt daher: weniger Fehler, mehr Regelmäßigkeit, mehr Zeit für Entscheidungen.
2. Er kann auch Massencontent erzeugen, und das ist ein Risiko
Ein Harness macht es sehr leicht, Hunderte Seiten zu produzieren. Google ist da eindeutig: Viele Seiten mit KI zu erzeugen, ohne den Nutzern einen Mehrwert zu bieten, kann gegen die Richtlinie zum Missbrauch von Inhalten in großem Maßstab verstoßen, und Websites, die gegen die Spam-Richtlinien verstoßen, können schlechter platziert werden oder aus den Ergebnissen verschwinden. Ein guter Harness lässt sich auch so einstellen, dass er Nein sagt: menschliches Gegenlesen, Quellenprüfung, keine Seite für ein einziges Keyword.
3. Harnesses sind auch Ihre neuen Besucher
Das ist der am meisten unterschätzte Punkt. Wenn ChatGPT, Claude oder ein Browsing-Agent eine Frage beantwortet, ist es ein Harness, der Ihre Seiten abruft und liest. Vercel und das Labor ora.ai haben zwischen Juni und August 2026 1.033 Agentensitzungen auf 25 Websites beobachtet:
Von 1.023 Antworten, deren Herkunft sich nachverfolgen ließ, stammten 844, also 82,5 %, von einer tatsächlich abgerufenen Seite.
In ihren kontrollierten Tests wurde eine hinter JavaScript versteckte Antwort von einem Client, der die Seite lediglich herunterlädt, nicht abgerufen. Ein
403-Fehler blockierte beide getesteten Clients.
Ihre Ergebnisse beschreiben ihre Stichprobe, nicht das gesamte Web, und das betonen sie auch. Aber die Lehre für GEO ist eindeutig: Eine Seite, die in HTML lesbar und ohne Blockade erreichbar ist, hat bessere Chancen, von einem Agenten zitiert zu werden. Das technische Basis-SEO wird zur Voraussetzung, um in den Antworten der Agenten vorzukommen.
Was ich an Ihrer Stelle tun würde
Einen Harness wählen und drei Wochen dabei bleiben, bei realen SEO-Aufgaben: monatliches Audit, Positionsmonitoring, technische Kontrolle.
Ihre Methoden als Skills schreiben statt als hineinkopierte Prompts: eine Skill pro Prozess, mit eigenen Regeln und Kontrollen.
Ihre Daten anbinden (Search Console, Analytics, Crawler), per MCP, damit der Agent mit echten Daten arbeitet.
Jedem Ergebnis einen Sensor hinzufügen: Eine Zahl wird in ihrer Quelle geprüft, bevor sie rausgeht.
Ihre Seiten so testen, wie ein Agent sie sieht: Rufen Sie sie ohne JavaScript ab und prüfen Sie, ob die Antwort im HTML steht.
Fazit
Der Harness ist die Hälfte des Agenten, über die vor einem Jahr niemand sprach. Die Messungen von 2026 zeigen, dass er bei gleichem Modell ein Ergebnis um mehrere Dutzend Punkte verschieben kann. Zur Auswahl gehen Sie von Ihrer Aufgabe aus, testen an Ihren eigenen Fällen und halten Ihre Methoden in offenen Formaten.
Für das SEO gibt es keine Abkürzung: Ein Harness lässt eine Website nicht ranken. Er macht die Arbeit verlässlicher, er kann auch wertlosen Content industrialisieren, und er ist inzwischen der Besucher, der entscheidet, ob Ihre Seiten zitiert werden. Auf diesen drei Feldern entscheidet sich alles.